工具会过时,框架不会——拆解 autoresearch 背后的迭代方法论【通俗易懂版】
作者体验了 Karpathy 开源的 autoresearch 后,认为它的价值不在代码本身,而在「改一个东西 → 打分 → 分高保留、分低回滚 → 再改下一个」这套通用迭代框架。文章拆解了这套逻辑,并给出两个落地例子:一位推友把它用于自媒体文章评审(规则核查加读者视角的双层打分),作者本人把它用于小红书帖子的质量评分,通过 6 条、后来扩到 8 条 yes/no 标准,在两轮测试中把有 Skill 与无 Skill 的差距从 33% 拉到 62%。最后给出不需要写代码的起步方法:找到一件反复做但结果忽好忽坏的事,把「什么叫好」拆成几个是非题。
前两天我发了一条帖子,推荐了 Karpathy 新开源的 autoresearch。

这个库很神奇,630 行 Python 代码,开源,短短几天就冲到了 5 万 star。我看到之后好奇心上来了,直接下载下来体验了一遍,发现确实很有东西。
帖子发完之后,陆续有很多推友私信问我:这东西到底怎么用?我不懂 ML,能用吗?
所以今天我就以最通俗易懂的方式,给大家拆解一下它背后的思路,以及我自己是怎么把它用在内容生成上的。
大多数人以为它只是个 ML 工具,看了一眼代码就关掉了。但这个项目真正值钱的地方,不在代码,在思路。
核心逻辑只有一句话
Karpathy 的 autoresearch 核心逻辑只有一句话:
改一个东西 → 打分 → 分高了保留,分低了回滚 → 再改下一个。
他用这个循环来优化 AI 模型训练代码。每次改一点参数或结构,训练 5 分钟,看验证损失有没有降,降了就留着,没降就还原,然后继续下一轮。一晚上能跑 100 次实验,不需要人盯着。
听起来很技术?把「训练代码」换成任何东西:
- 换成广告文案 → 改一个标题,测点击率,好的留着
- 换成冷启动邮件 → 改一句开场白,测回复率,好的留着
- 换成产品定价策略 → 改一个价格锚点,测转化,好的留着
- 换成 AI 生成的内容 → 改一条 prompt 规则,打分,好的留着
这不是 ML 工具,这是一个通用的迭代框架。任何你能打分的东西,都能套进去自动优化。
已经有推友跑起来了
我在写这篇文章的时候,看到评论区已经有人把他的实践贴出来了(截图见下):
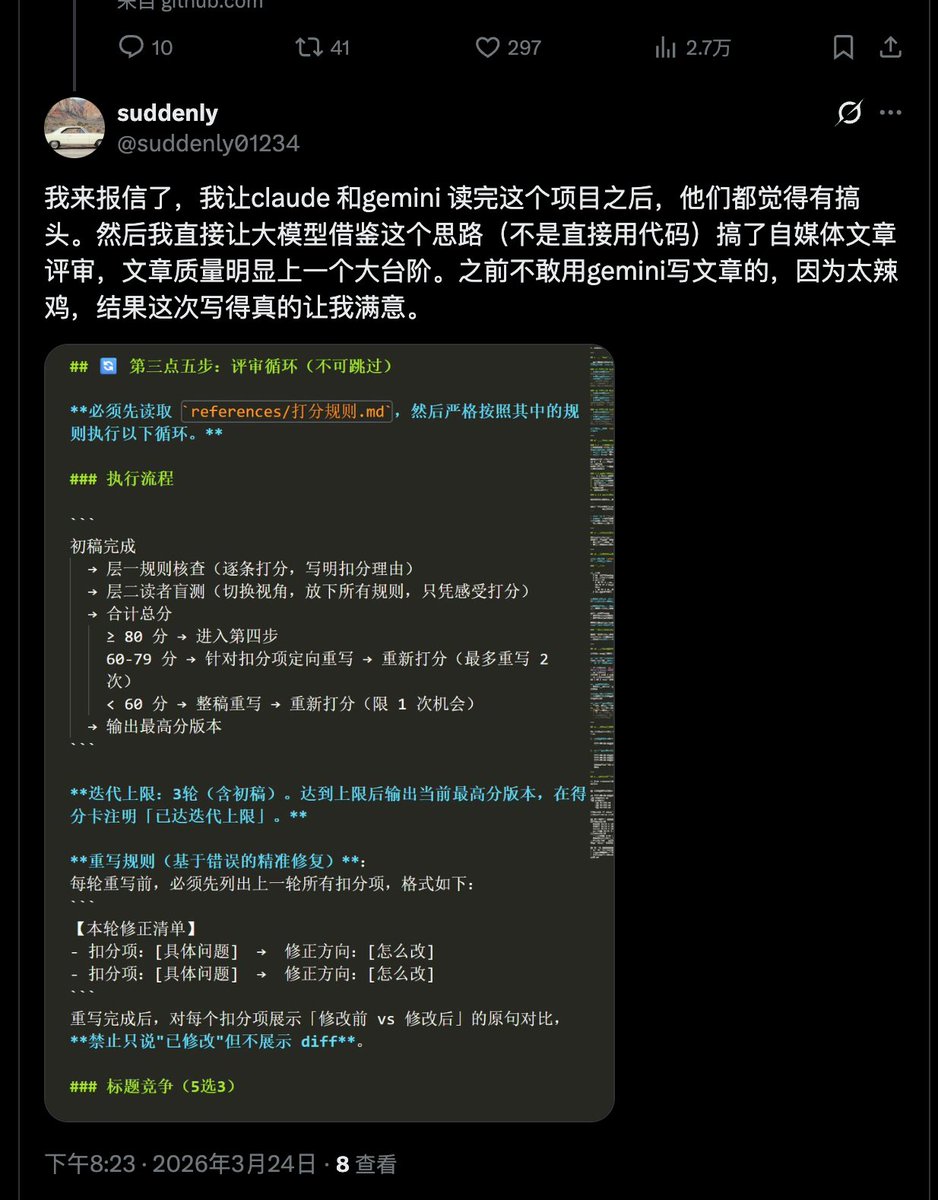
我让 Claude 和 Gemini 读完这个项目之后,他们都觉得有搞头。然后我直接让大模型借鉴这个思路(不是直接用代码)搞了自媒体文章评审,文章质量明显上一个大台阶。之前不敢用 Gemini 写文章,因为太辣鸡,结果这次写得真的让我满意。
他的具体做法是给 AI 设计了一套双层打分:
- 第一层,按规则逐条核查,类似 checklist,每条要么过要么不过。
- 第二层,切换成「读者视角」,放下所有规则,只凭感受打分。
两层分数加在一起,再决定这篇文章是直接通过,还是针对扣分项定向重写,还是整稿推倒重来。
他把客观规则和主观感受都考虑进去了,这个思路比大多数人能想到的都要完整。而且他没有用 Karpathy 的一行代码,只是借了那个「打分 → 改 → 再打分」的框架。
我自己怎么用的
我在用 AI 批量生成小红书帖子,有个老问题:有时候出来的挺好,有时候平庸,但说不清差在哪里。
autoresearch 的思路给了我一个切入点:把「感觉不对」变成可以打分的标准,问题就能被系统性地修掉。
我设计了 6 条 yes/no 问题作为第一轮评分标准:
- 第一句话有没有具体数字或强反差?
- 有没有用日常生活的比喻解释技术概念?
- 有没有具体可验证的数字(不是「效果很好」这类空话)?
- 有没有出现「在当今AI飞速发展」「改变游戏规则」这类套话?
- 结尾的互动问句够不够具体,用户能直接回答吗?
- 字数在 150-600 字之间吗?
为什么是 yes/no,不是 1-10 分?
因为打分有主观性,同一篇帖子今天打 7 分,明天可能打 6 分。但「第一句话有没有数字」是客观事实,不会漂移。标准越客观,迭代越稳定。
两轮数据,差距从 33% 扩大到 62%
第一轮:有 Skill vs 无 Skill,6 条标准,三个测试主题。
结果:有 Skill 100%,无 Skill 66.7%,差距 +33%。
但我看完输出发现,有 Skill 的帖子还有两个问题没被捕捉到:标签全是技术圈的冷词(#LLM #代码优化),用户根本不搜这些;帖子里没有任何一句话是可以单独截图传播的。
这不是 AI 不努力,是我的 Skill 没有要求它做这件事。
于是我在 Skill 里加了两条规则,checklist 也从 6 条扩到 8 条,跑第二轮。
结果:有 Skill 仍然 100%,无 Skill 掉到 37.5%,差距 +62%。
来看同一个主题「介绍 autoresearch」的前后对比:
第一轮开头:
630行代码,Karpathy让AI自己做实验,全程不需要人工干预 🤯
第二轮开头 + 金句:
630 行代码,AI 自己做实验改代码,一晚上跑 5 万次。想象你在反复调整菜谱。今天加点盐,明天换个火候,后天改比例。autoresearch 就是让 AI 自动做这件事,但速度快到你根本想象不到。别被 5 万 star 唬住,这东西的真正价值不在用起来有多简单,而在它改变了研究和优化的思路方式。
比喻从「科学家的脑子」变成「调菜谱」,金句独立成段,标签全换成了热门词。Skill 学会了,无 Skill 的版本还是老样子。
真正值钱的东西:框架思维
我和那位推友做的事情,表面上是两件不同的事,我在优化内容生成,他在做文章评审。但背后用的是同一个框架:
定义「好」的标准 → 执行 → 打分 → 找出差距 → 改 → 重复。
这个框架不属于任何工具,不属于任何平台。Karpathy 把它用在 ML 训练上,你可以把它用在任何地方。
有框架思维和没有框架思维的区别是:没有框架的人看到 autoresearch,觉得「这是个 ML 工具,跟我没关系」;有框架思维的人看到它,脑子里自动映射出十个可以套用的场景。
大多数时候,限制你的不是工具,是你有没有把眼前这件事抽象成一个可以复用的思路。
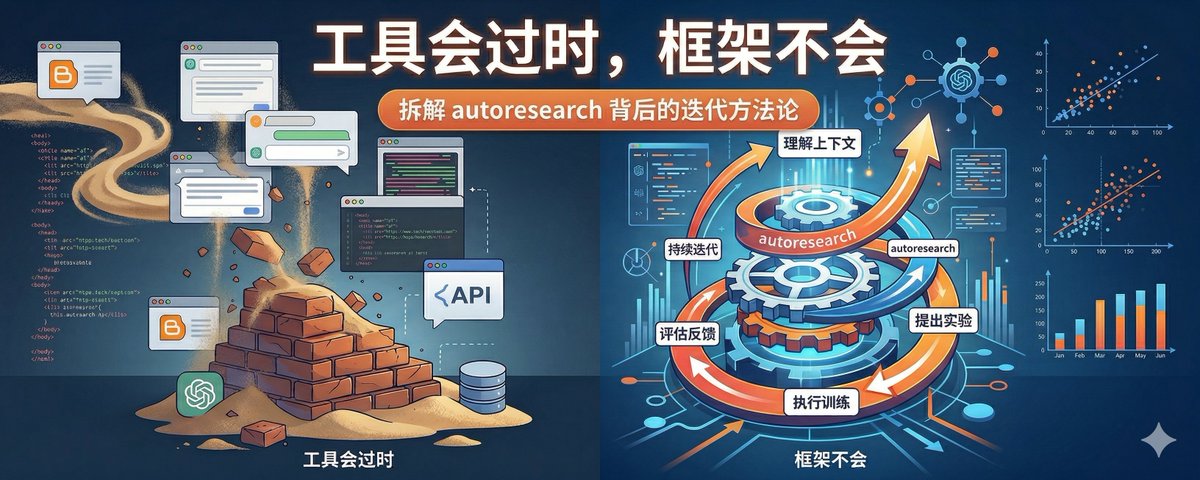
工具会过时,框架不会。Karpathy 今天开源的是 630 行代码,但他真正贡献的,是一个任何人都能拿走的迭代方法论。
怎么开始
不需要跑代码,不需要懂 ML。
只需要想清楚一件事:你手边有没有一件重复在做、但结果时好时坏的事?
如果有,试着回答这个问题:什么样的结果算好?能不能拆成几个具体的是非题?
能回答这个问题,你就已经有了开始迭代的全部条件。
剩下的,交给 AI 去跑。
以上,写的仓促,不够深入,凑合看吧😄。
仓库在这里,感兴趣的可以去看:https://github.com/karpathy/autoresearch
本文提及与引用
原文提到的内容里,已在本站整理好的可以直接接着读;标注「原文来源」的还没有整理成站内文章。
- 🚀630 行代码,开源,MIT协议。内嵌推文 · 已采集入库,待审核通过后自动挂上链接
内容核验说明
作者把 Karpathy 的 autoresearch 从 ML 语境里抽出来,落到「定义标准、打分回滚、再改」这套循环上,并给出自媒体评审和小红书评分的具体拆法,yes/no 清单那部分最好用。适合用 AI 批量做内容、又苦于质量忽好忽坏的人。
文中 630 行代码、5 万 star、有 Skill 与无 Skill 的 33% 和 62% 差距、6 条扩至 8 条等数据均来自作者公开披露,诀.com未独立验证,作者自述的测试结果不保证复现;文中提到的推友案例为他人转述截图,同样未经核验。评论区整合
根据评论整合来看,多数人认可这套「定标准、执行、打分、迭代」的框架足够普适,有人已经动手把它泛化成能套复杂任务的 harness,也有人打算拿来试长文写作 agent。少数声音提出框架本身同样会过时,真正稀缺的是把模糊问题压缩成结构并推动它跑起来的能力,认为工具思维容易被误当成终点。整体以认可和愿意实践为主,质疑集中在框架的生命力上。
基于原帖公开评论整理,只反映讨论中的观点与反馈,不代表诀.com 立场。原始来源
原作者:Lonely(@Lonely__MH)
本文对公开来源内容进行了结构化整理,原观点与内容归原作者所有。
查看原文