我是怎么用 Codex 做小红书,2 天涨了 1000 粉
作者从 X 上看到的小红书账号出发,拆解出“熟悉物品 + 陌生英文名 + 好奇心问题”的选题模型,并用 Codex 辅助执行,前期只发几篇笔记后获得 105.1 万曝光、18.4 万观看、封面点击率 17.9%,2 天涨 1000 粉。
答应大家的 X 涨到 2000 粉,分享小红书起号攻略,来交作业了。
先说结果
这个账号我基本没手动做内容,前期只发了几篇笔记,就拿到了:
- 105 万曝光
- 18 万观看
- 后面 2 天涨了 1000 粉
整个项目的起点,只是我在 X 上刷到了这篇帖子。
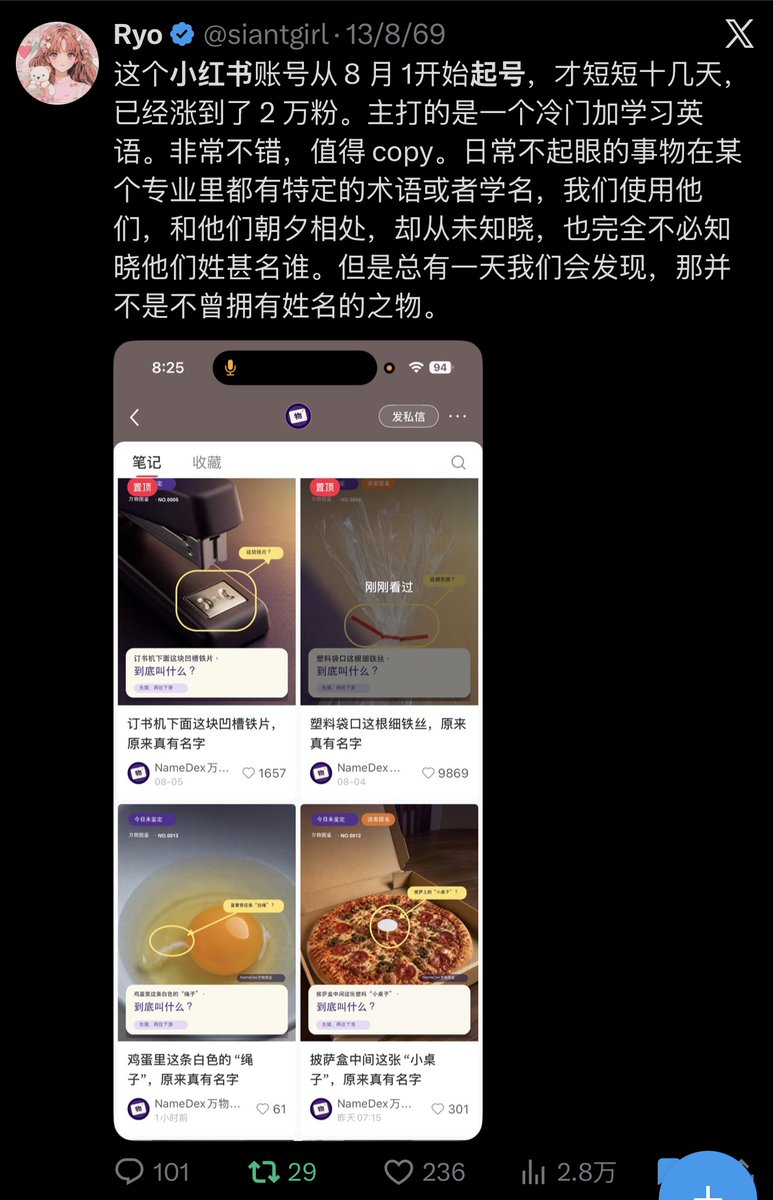
对方分享了一个刚起不久的小红书账号。
内容模型:熟悉的东西 + 陌生的英文名
它做的内容非常简单:
专门讲那些生活中天天见,但大多数人不知道“英语叫什么”的东西。
比如:
- 披萨盒中间的小塑料架,英文叫什么?
- 鸡蛋里的白色“绳子”,英文叫什么?
- 订书机下面那块铁片,英文叫什么?
这些东西大家都见过,甚至每天都在用。
但真让你说出它们的英文名字,大多数人都答不上来。
所以这个内容模型其实很清晰:
熟悉的东西 + 陌生的英文名 + 一个好奇心问题。
用户刷到以后,很容易产生一种感觉:
“这个我天天见,还真不知道英语怎么说。”
这就是它的信息差。
为什么我觉得可以复制
我当时看到以后,第一反应不是直接搬它的内容,而是觉得:
这个选题模型可以复制,而且特别适合用 AI 批量生产。
于是我把这个账号的逻辑拆了下来:
找生活中的常见物品 → 找它真正的英文名称 → 补充一点相关知识 → 做成统一风格的图片。
把执行交给 Codex
接下来,我直接把执行交给 Codex。
我的流程基本是:
找选题 → 查英文名称 → 核对资料 → 写标题 → 做图片 → 排版。
我只负责:
定方向 + 审核。
选题标准
选题标准也很简单:
这个东西是不是大家都见过,但大多数人不知道它英语叫什么?
如果答案太明显,就不做。
如果看到答案以后会有一种:
“原来这个东西英语叫这个!”
那就是一个不错的选题。
选题也有一个很简单的标准:
用户看到答案以后,会不会产生“原来这东西还有名字”的感觉?
如果没有信息差,就不做。
这类内容适合做小红书封面
这类内容还有一个优势:
特别适合做小红书封面。
一个熟悉的东西,加一个圈、一个箭头,再问一句:
“这个叫什么?”
用户 0.5 秒就能看懂。
数据与迭代
数据出来以后,我也没有急着换玩法。
哪个内容结构有效,就继续做类似内容。
因为小红书起号阶段最重要的不是天天创新,而是:
不断强化一个已经被验证的内容模型。
最后的数据
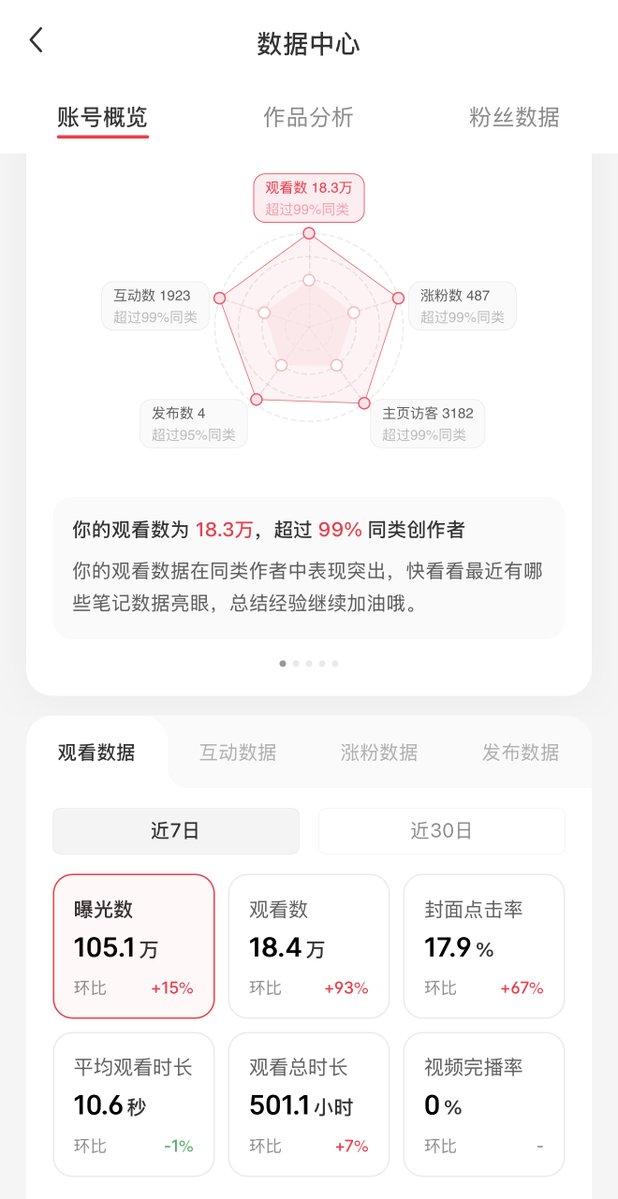
- 曝光 105.1 万
- 观看 18.4 万
- 封面点击率 17.9%
后面继续跑,2 天涨了 1000 粉,目前数据还在涨!
这次实验最大的感受
这次实验让我最大的感受是:
现在做内容,我不会从 0 开始想。
而是先去找:
什么样的东西已经跑出来了?
然后拆解它的:
选题模型、流量模型、视觉模型。
最后再用 AI 快速执行。
整个流程其实就是:
发现 → 拆解 → 模仿 → 迭代。
这里的模仿不是搬运。
而是:
复制已经被验证的底层逻辑,再重新生产自己的内容。
AI 时代真正被大幅降低的,不仅仅是内容生产成本。
还有:
从发现一个机会,到真正把它做出来的时间。
以前看到一个项目,可能研究一周还没开始。
现在看到一个能做的模型:
当天拆,当天发,市场直接给答案。
这就是我这次小红书起号最核心的方法。
内容核验说明
作者把一个小红书起号案例拆成可复用的选题模型,常见物件配上多数人不知道的英文名,再用一句提问做封面。值得留下的是这套拆解方式,找已经跑通的内容,复制它的底层逻辑,把执行环节交给 Codex,人只做定方向和审核。做内容起号或想看 AI 落地怎么分工的人可以读。曝光和涨粉数据来自作者自己披露,诀.com 未独立验证,全文也没谈变现。
文中 105.1 万曝光、18.4 万观看、17.9% 封面点击率、2 天涨 1000 粉等数据均来自作者公开披露,诀.com 未独立验证;Codex 的具体用法与产出效果无第三方证据,结果不保证复现。评论区整合
根据评论整合来看,多数人认可这套拆解和分工,有人把它概括为流程执行、人只负责判断,表示看完想马上试,也有人说已经收藏准备晚点动手。疑问主要是后期怎么变现,以及这篇早点发时没什么阅读量、为何现在又爆了。还有人担心光看学不会。整体认可方法,但没人给出变现答案。
基于原帖公开评论整理,只反映讨论中的观点与反馈,不代表诀.com 立场。原始来源
原作者:Andy L(@AndyL5cc)
本文对公开来源内容进行了结构化整理,原观点与内容归原作者所有。
查看原文