从零跑通 Microduck 强化学习训练与仿真模拟
这篇内容记录从零跑通 Microduck 强化学习训练与仿真的工程流程,前半部分介绍项目组成、训练与仿真分工、PPO 与策略控制原理、软硬件环境,以及训练和仿真环境的配置步骤,并进入训练方案制定。;本段内容覆盖 Microduck 强化学习训练与仿真的后半程:奖励与域随机化配置、PPO 参数、执行计划、W&B 配置、正式训练与监控、checkpoint 横向选择、ONNX 导出与数值检查、模型下载、MuJoCo 策略仿真、场景测试、验收标准、实机部署检查顺序,以及常见问题排查。
目录
- Microduck 项目组成部分
- 训练和仿真分别在做什么
- 什么是 PPO
- 策略如何控制机器人
- 开发设备
- 已验证的软硬件组合
- 配置训练环境
- 配置仿真环境
- 制定训练方案
- 开始训练
- 训练过程观察
- checkpoint 横向选择
- 导出 ONNX
- 模型下载
- 启动策略仿真
- 场景测试
- 验收标准
- 从仿真走向实机
- 常见问题
相关术语
- MuJoCo:负责机器人刚体、关节、碰撞和接触的物理引擎
- Warp:让大量 MuJoCo 环境在 NVIDIA GPU 上并行计算的组件
- mjlab:组织机器人任务、观测、奖励、随机化和训练配置的框架
- PPO:通过限制单轮更新幅度来稳定训练的策略优化算法
- Actor:从观测生成动作的策略网络
- Critic:在训练时估计状态价值的网络
- Reward:希望策略增加的行为得分
- Penalty:希望策略减少的行为代价
- Domain randomization:随机改变物理和传感器参数,提高策略适应性
- Checkpoint:可继续训练的 PyTorch 快照
- ONNX:脱离训练框架运行的模型交换格式
- W&B:保存训练曲线、配置和运行记录的实验管理工具
- Sim-to-real:将仿真中训练的策略迁移到真实机器人的过程
- Recovery latch:起身期间锁住恢复策略,确认站稳后才交回行走控制
不熟悉 PPO、MuJoCo 或 ONNX 也没关系,前几章会先把这些概念连起来,再进入命令和配置。已经熟悉强化学习的读者,可以从第 6 章查看版本要求,再到第 7 章搭环境。
Microduck 项目组成部分
项目主要分布在两个仓库。
- pollen-robotics/microduck:机器人运行时、板端服务、控制状态机、策略槽位和部署配置
- pollen-robotics/microduck_rl:机器人模型、MuJoCo 场景、强化学习任务、PPO 训练、模型导出和仿真工具
可以把两者理解成驾校和真正的汽车。microduck_rl 是训练场,负责让策略学会动作。microduck 是运行系统,负责读取传感器、选择策略、限制动作并把目标发送给舵机。
使用的目录结构如下:
microduck/
├── runtime/        pollen-robotics/microduck
├── microduck_rl/   pollen-robotics/microduck_rl
└── artifacts/      checkpoint、ONNX 和评测结果
从训练到仿真的数据流顺序如下:
- MuJoCo 机器人与场景
- 4096 个并行环境
- PPO 训练
- PyTorch checkpoint
- 选择候选模型
- 导出 ONNX
- Mac CPU 仿真
- 完整控制链验收
- 机器人运行时
这里有两次容易混淆的转换:
- 训练阶段保存的 .pt 文件,包含策略网络、价值网络、优化器状态和训练进度,适合继续训练。
- 部署阶段使用的 .onnx 文件,只保留推理需要的策略,体积更小,不依赖训练框架。
训练和仿真分别在做什么
仿真,是让虚拟机器人按照物理规律运动。训练,则是在仿真循环外,再加一层学习算法,根据运动结果更新神经网络。
一次训练迭代大致会经过这些步骤:
- 给每个环境生成一组速度和姿态命令
- 策略读取观测并输出关节动作
- MuJoCo 推进物理世界
- 环境计算奖励、惩罚和终止条件
- PPO 用这一批轨迹更新网络
- 所有环境继续采样,进入下一轮
训练结束后的仿真,不再更新网络,只加载已经固定的 ONNX,根据键盘命令不断做前向计算。这样可以观察策略学到了什么,验证运行时的策略切换和安全逻辑。
- 训练:网络会更新,硬件为 RTX 4090,目的是从大量经验中学出策略
- 批量评测:网络不会更新,硬件为 RTX 4090,目的是用数百个环境统计成功率
- 交互仿真:网络不会更新,硬件为 Mac CPU,目的是观察动作并手动操作
- 机器人运行:网络不会更新,硬件为机器人计算板,目的是实时控制舵机
什么是 PPO
PPO 的全名是 Proximal Policy Optimization,中文译作:近端策略优化。名字有些抽象,它解决的问题其实很好理解。
假设策略刚刚找到一个勉强能走两步的动作,如果一次更新把网络参数改得太多,新策略可能连站立都忘了。PPO 会限制每轮更新的幅度,让策略在现有能力附近逐步改善。它允许探索,只是不鼓励突然变成一套完全不同的动作。
强化学习中的几个角色
- 环境:一只 MuJoCo 机器人和它所在的地面
- 观测:IMU、关节位置、关节速度、上一动作和控制命令
- 动作:14 个关节的目标偏移
- 奖励:速度跟踪、直立、抬脚和姿态跟踪等得分
- 惩罚:打滑、碰撞、摇晃和动作突变等代价
- 策略:从观测映射到动作的神经网络
- rollout:策略在环境中连续运行得到的一段轨迹
- iteration:收集一批轨迹并更新一次网络的训练循环
Actor 和 Critic
PPO 训练中有两个网络。
Actor,是真正做动作决定的网络。它看到当前观测后,给出下一步应该发送给 14 个关节的动作。
Critic,不直接控制机器人,主要是估计当前状态未来大约能获得多少总奖励。实际结果比 Critic 的预期好,说明这次动作值得鼓励。实际结果更差,说明相应动作的概率应该降低。
训练完成后只需要 Actor,Critic 不会进入 ONNX。
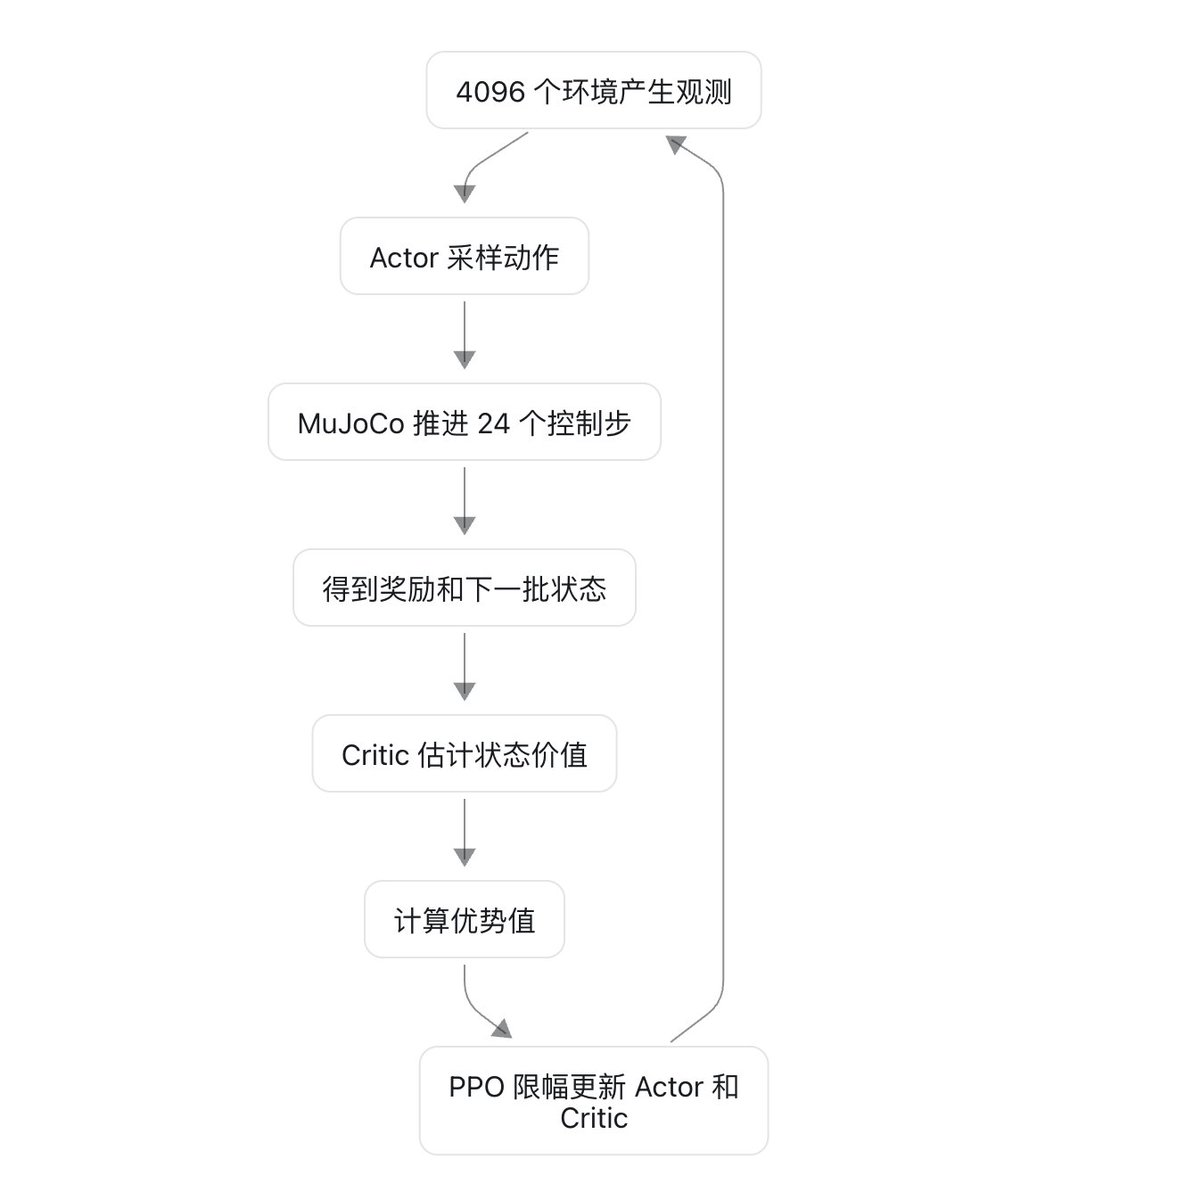
优势值可以理解为这次表现比原先预期好多少。正优势会提高对应动作再次出现的概率,负优势会降低它。
PPO 最有代表性的部分是限幅目标。
L = E[min(r × A, clip(r, 1 - ε, 1 + ε) × A)]A 是优势值,r 表示新旧策略产生同一动作的概率比。clip 会把概率变化限制在一个小范围内。本项目的裁剪范围为 0.2。
公式不需要记,只要知道它的作用是让每次学习迈小步,降低好不容易学会的动作被一次更新破坏的风险。
一轮训练包含多少数据
本次训练使用 4096 个环境,每个环境每轮采样 24 个控制步。
4096 × 24 = 98,304 个样本每轮
98,304 × 5000 = 491,520,000 个样本
接近五亿个样本,4096 只机器人会同时计算,RTX 4090 大约两小时就可以完成这次训练。GPU 并行仿真的价值就在这里。
策略如何控制机器人
策略每秒运行 50 次。
MuJoCo 的物理步长为 0.005 秒,每推进 4 个物理步调,用一次策略,因此控制周期为 0.02 秒。
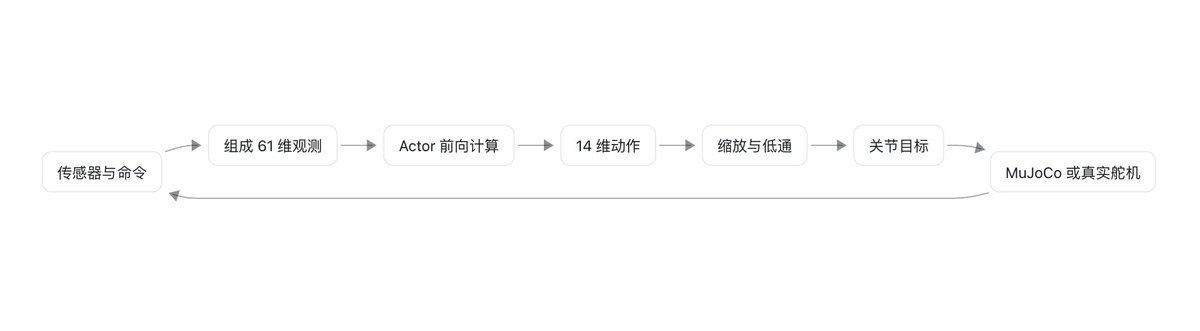
61 维观测
- 机身角速度:3 维,告诉策略身体正在怎样旋转
- 投影重力:3 维,表示机身相对竖直方向的姿态
- 关节相对位置:14 维,表示当前姿势
- 关节速度:14 维,表示各关节运动趋势
- 上一时刻动作:14 维,帮助策略生成连续动作
- 速度命令:3 维,前后、侧向和转向目标
- 头部姿态命令:4 维,颈部和头部的目标姿态
- 身体姿态命令:6 维,三维位置和三维角度目标
- 合计:61 维,ONNX 的固定输入宽度
输出是 14 个关节目标偏移,对应头部 4 个关节和双腿 10 个关节。
训练、导出、仿真和机器人运行时,必须使用同样的顺序。只要观测顺序错一位,模型可能成功加载,但动作没有意义。
奖励怎样塑造步态
强化学习不会自动理解走路这个词,环境需要把好动作写成可以计算的分数。
- 线速度跟踪:按命令前进、后退和侧移
- 角速度跟踪:按命令转向
- 直立奖励:保持身体竖直
- 腾空时间:形成左右脚交替的步态
- 抬脚高度:减少拖脚
- 头部姿态跟踪:运动时仍能控制头部
- 脚底打滑代价:减少无效滑动
- 身体角速度代价:减少剧烈摇晃
- 动作变化代价:让相邻控制周期更平滑
- 自碰撞代价:避免腿部撞到机身
总奖励是这些项目的加权和。奖励太偏向速度,机器人可能用剧烈动作换取短时前进。平滑和稳定代价太重,又可能让它不愿抬脚。
配置使用分阶段课程,先让步态形成,再逐渐加强动作平滑和静止能力。
做域随机化
仿真中的质量、摩擦和传感器都很理想,真实机器人却总会有偏差。两台同型号舵机也可能有不同摩擦,电池电压会变化,IMU 安装会有小角度误差,脚垫和地面的摩擦更不可能永远固定。
域随机化会在训练时主动改变这些参数。策略看到的不是一台参数恒定的机器人,而是一整个相近机器人的集合。它学到的动作通常更稳健,也更有机会迁移到实机。
本次行走任务使用的主要随机化如下:
- 脚底摩擦:0.7 到 1.3
- 质量与惯量:标称值的 0.95 到 1.05 倍
- 关节摩擦:标称值的 0.9 到 1.1 倍
- 转子惯量:标称值的 0.9 到 1.1 倍
- 躯干质心:由 3 毫米逐步扩大到 15 毫米
- 头部质心:由 3 毫米逐步扩大到 10 毫米
- IMU 安装误差:最多 6 度
- 编码器偏差:每关节正负 0.015 弧度
- 关节速度观测:延迟一个控制周期
- 外部扰动:每 3 到 6 秒加入正负 0.3 m/s 的速度变化
BAM 做什么
MuJoCo 负责刚体、关节、碰撞和接触,BAM 负责更接近真实舵机的执行器行为。它考虑电压控制、反电动势、摩擦和负载等因素。
对一台只有 800 克、使用小型舵机的双足机器人来说,执行器响应的差异会明显影响步态,所以训练时不能只使用理想的关节位置控制器。
开发设备
本文用 RTX 4090 训练,用 Mac mini 仿真。当然你也可以用更高端的机器。
MuJoCo Warp 能把大量环境并行放在 NVIDIA GPU 上推进。RTX 4090 除了让神经网络算得快,还同时计算几千只机器人的物理过程。
Mac 上的单机器人 CPU 仿真已经足够流畅,适合观察动作和调试键盘控制。但用同样方式推进 4096 个训练环境,效率远低于 CUDA GPU。
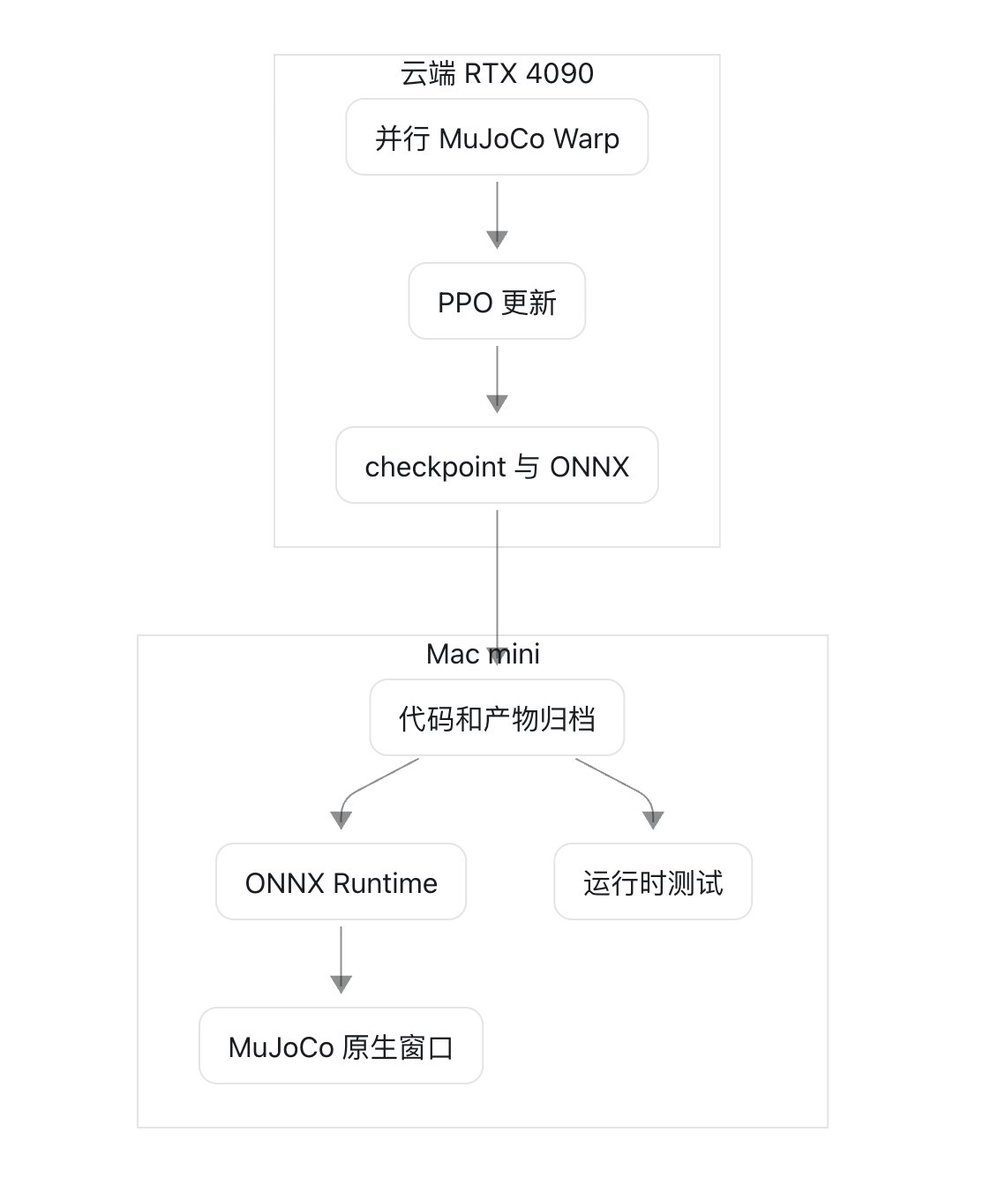
- 主要任务:训练机负责训练和批量评测;Mac mini 负责开发、验收和交互仿真
- GPU:训练机为 RTX 4090 24 GiB;Mac mini 不要求 CUDA
- 推理设备:训练机为 CUDA;Mac mini 为 CPU
- 图形窗口:训练机通常不用;Mac mini 使用 MuJoCo 原生 viewer
- 数据交换:训练机生成 checkpoint 和 ONNX;Mac mini 通过 SCP 接收并归档
已验证的软硬件组合
这套版本已经完成训练、导出和仿真闭环。
- GPU:RTX 4090 24 GiB
- NVIDIA 驱动:595.71.05
- Python:3.12
- uv:0.12.8
- PyTorch:2.9.1+cu128
- Warp:1.12.0
- mjlab:1.3.0
- MuJoCo:3.10.0
- BAM:1.0.1
- microduck_rl 提交:5946fd9cdbc58956424420153e51975af3b30d77
- microduck 提交:9f7eaad1008fffd90ef871a33a18aecd066b51a9
RTX 4090 服务器建议至少准备 8 个 CPU 核心、32 GiB 内存和 20 GiB 可用数据盘。
配置训练环境
下面从一台已经装好 NVIDIA 驱动的 Linux 云主机开始。
连接并检查 GPU
在 Mac 终端中填入云平台提供的地址和端口:
SSH_HOST=你的服务器地址
SSH_PORT=你的服务器端口
SSH_KEY="$HOME/.ssh/microduck_4090"

ssh -i "$SSH_KEY" -p "$SSH_PORT" root@"$SSH_HOST"
登录后执行:
nvidia-smi
需要看到 GPU 型号、驱动版本和显存信息。如果这一步无法识别 GPU,应先处理云主机镜像或驱动。
安装 uv
uv 负责创建 Python 3.12 环境,并严格按照锁文件安装依赖。
curl -LsSf https://astral.sh/uv/install.sh | sh
source /root/.local/bin/env
uv --version
准备持久目录
mkdir -p /root/autodl-tmp/uv-cache
mkdir -p /root/autodl-tmp/artifacts
mkdir -p /root/autodl-tmp/backups
把仓库、环境缓存、日志和模型放在数据盘。
/root/autodl-tmp/
├── microduck_rl/
├── uv-cache/
├── artifacts/
└── backups/
获取训练代码
cd /root/autodl-tmp
git clone https://github.com/pollen-robotics/microduck_rl.git
cd microduck_rl
git checkout 5946fd9cdbc58956424420153e51975af3b30d77
固定提交可以避免环境定义在训练过程中变化。将来升级仓库时,建议新建一份实验目录,不要直接覆盖已经验收的环境。
安装依赖
cd /root/autodl-tmp/microduck_rl
export UV_CACHE_DIR=/root/autodl-tmp/uv-cache
export UV_HTTP_TIMEOUT=600

uv sync --frozen
--frozen 要求依赖和 uv.lock 一致。
检查 Python 和 CUDA
cd /root/autodl-tmp/microduck_rl
export UV_CACHE_DIR=/root/autodl-tmp/uv-cache

uv run python - <<'PY'
from importlib.metadata import version
import torch

print("PyTorch", torch.__version__)
print("PyTorch CUDA", torch.version.cuda)
print("CUDA available", torch.cuda.is_available())
print("GPU", torch.cuda.get_device_name(0))

for package in ("warp-lang", "mjlab", "mujoco", "better-actuator-models"):
    print(package, version(package))

assert torch.cuda.is_available()
PY
预期结果中应出现 True 和 RTX 4090。
再检查测试和任务注册。
uv run --with pytest pytest tests/
uv run list-envs | grep Mjlab-Velocity-Flat-MicroDuck
环境验收大致会得到 166 项测试通过,1 项按平台条件跳过。
配置仿真环境
在 Mac mini 开发机上配置。
安装工具
brew install uv rust
Python 由 uv 管理,不必另外创建 Conda 环境。
建立工作目录
PROJECT_ROOT="$HOME/projects/microduck"
mkdir -p "$PROJECT_ROOT"
cd "$PROJECT_ROOT"

git clone https://github.com/pollen-robotics/microduck.git runtime
git -C runtime checkout 9f7eaad1008fffd90ef871a33a18aecd066b51a9

git clone https://github.com/pollen-robotics/microduck_rl.git microduck_rl
git -C microduck_rl checkout 5946fd9cdbc58956424420153e51975af3b30d77

mkdir -p artifacts
安装 Python 环境
cd "$PROJECT_ROOT/microduck_rl"

export UV_CACHE_DIR="$PROJECT_ROOT/.uv-cache"
export XDG_CACHE_HOME="$PROJECT_ROOT/.cache"
export MPLCONFIGDIR="$PROJECT_ROOT/.cache/matplotlib"
export WARP_CACHE_PATH="$PROJECT_ROOT/.cache/warp"

uv sync --frozen
uv run --with pytest pytest tests/
这些变量把缓存留在项目目录中,也避开 macOS 对部分用户缓存目录的权限限制。可以把四行 export 加到 ~/.zshrc。
检查运行时
cd "$PROJECT_ROOT/runtime"
cargo test --workspace
控制链的验收大致包括 robotd 的 97 项单元测试、7 项 IPC 集成测试和 robotd-params 的 25 项测试。
制定训练方案
本节以平地行走策略为例。
训练任务为 Mjlab-Velocity-Flat-MicroDuck,策略从随机初始化开始学习,不依赖预训练模型。
一个策略处理静止、前进、后退、侧移和转向,速度命令为零时,策略学习保持站立。推理阶段只调用这一张 ONNX,不包含额外策略或切换状态机。
训练目标和接口
策略需要同时满足三个目标。
- 跟踪前后速度、侧向速度和转向角速度
- 在运动和零命令状态下维持机身稳定
- 保持动作平滑,减少拖脚、打滑和自碰撞
Actor 接收 61 维观测并输出 14 维动作:
- 基座角速度:3 维,IMU 角速度
- 投影重力:3 维,机身坐标系中的重力方向
- 关节位置:14 维,相对默认姿态的关节偏移
- 关节速度:14 维,当前关节速度
- 上一时刻动作:14 维,前一个控制周期的策略输出
- 控制命令:13 维,速度 3 维、头部姿态 4 维、身体姿态预留 6 维
- Actor 输出:14 维,关节目标位置偏移
动作通过下面的关系转换为关节目标:
target_position = default_pose + action × action_scale
任务的 action_scale 为 1.0。训练端、ONNX 推理端和机器人运行时必须保持相同的观测顺序、关节顺序、默认姿态和动作缩放。
命令分布
任务配置位于 src/mjlab_microduck/tasks/microduck_velocity_env_cfg.py,是 microduck_rl 仓库自带的任务源码。
命令分布的核心代码位于 make_microduck_velocity_env_cfg() 函数。设置时,保留原函数的其余配置,并加入下面这段代码。
from copy import deepcopy

from mjlab.managers import CurriculumTermCfg
from mjlab.tasks.velocity.mdp import UniformVelocityCommandCfg

from mjlab_microduck.tasks import mdp as microduck_mdp


NUM_STEPS_PER_ENV = 24
TURN_IN_PLACE_FRACTION = 0.15


# 以下内容放在 make_microduck_velocity_env_cfg() 内部。
# cfg = make_velocity_env_cfg() 已由原文件创建。

# deepcopy 避免修改其他任务共享的命令配置对象。
command: UniformVelocityCommandCfg = deepcopy(cfg.commands["twist"])

# 初始阶段保留 2% 的零速度环境。
command.rel_standing_envs = 0.02
command.rel_heading_envs = 0.0

# 三个速度分量使用固定训练范围。
command.ranges.lin_vel_x = (-0.4, 0.4)
command.ranges.lin_vel_y = (-0.3, 0.3)
command.ranges.ang_vel_z = (-1.0, 1.0)
command.viz.z_offset = 0.5

# 使用项目提供的命令类,并加入 15% 原地转向样本。
cfg.commands["twist"] = microduck_mdp.VelocityCommandCommandOnlyCfg(
    **vars(command)
)
cfg.commands["twist"].rel_turn_in_place_envs = (
    TURN_IN_PLACE_FRACTION
)

# 每个 PPO iteration 为每个环境采集 24 个控制步。
# 这里的 step 因此使用 iteration × 24。
cfg.curriculum["standing_envs"] = CurriculumTermCfg(
    func=microduck_mdp.standing_envs_curriculum,
    params={
        "command_name": "twist",
        "standing_stages": [
            {"step": 0,          "rel_standing_envs": 0.02},
            {"step": 500 * 24,   "rel_standing_envs": 0.05},
            {"step": 750 * 24,   "rel_standing_envs": 0.10},
            {"step": 1000 * 24,  "rel_standing_envs": 0.15},
            {"step": 1500 * 24,  "rel_standing_envs": 0.20},
            {"step": 2000 * 24,  "rel_standing_envs": 0.25},
        ],
    },
)
以上代码是命令分布部分的可读摘录,不是完整配置文件。make_velocity_env_cfg、VelocityCommandCommandOnlyCfg 和 standing_envs_curriculum 的实现已包含在仓库中。
- make_velocity_env_cfg:位于 mjlab 依赖包,用于创建通用速度任务配置
- VelocityCommandCommandOnlyCfg:位于 src/mjlab_microduck/tasks/mdp.py,用于生成普通速度命令和原地转向样本
- standing_envs_curriculum:位于 src/mjlab_microduck/tasks/mdp.py,用于按训练进度增加零速度环境比例
- make_microduck_velocity_env_cfg:位于 src/mjlab_microduck/tasks/microduck_velocity_env_cfg.py,用于组合 Microduck 的完整行走环境
任务注册位于 src/mjlab_microduck/tasks/__init__.py。注册代码把任务 ID、环境配置和 PPO 配置连接起来。
register_mjlab_task(
    task_id="Mjlab-Velocity-Flat-MicroDuck",
env_cfg=make_microduck_velocity_env_cfg(),
    play_env_cfg=make_microduck_velocity_env_cfg(play=True),
    rl_cfg=MicroduckRlCfg,
    runner_cls=MicroduckOnPolicyRunner,
)
修改后执行下面的命令检查任务能否被发现。
uv run list-envs | grep 'Mjlab-Velocity-Flat-MicroDuck'- 前后速度:-0.4 到 0.4 m/s
- 侧向速度:-0.3 到 0.3 m/s
- 转向角速度:-1.0 到 1.0 rad/s
- 原地转向样本比例:15%
- 静止命令比例:从 2% 逐步提高到 25%
原地转向使用独立采样比例,避免线速度与角速度完全独立采样时缺少纯转向数据。
静止命令采用课程式增加,训练早期优先形成步态,随后再提高停止和站立能力。
策略控制频率为 50 Hz。MuJoCo 物理步长为 0.005 秒,每四个物理步执行一次策略推理。
9.3 奖励和域随机化
奖励函数围绕速度跟踪、直立和步态质量配置:
- 线速度跟踪:权重 2.0,跟踪前后和侧向速度
- 角速度跟踪:权重 2.0,跟踪转向命令
- 机身直立:权重 2.0,限制持续倾斜
- 足部腾空时间:权重 3.0,形成稳定的交替步态
- 足部目标高度:0.02 m,减少拖脚
- 足底打滑:-0.1,降低接触期滑动
- 机身角速度:-0.05,减少摇晃
- 角动量:-0.02,抑制剧烈摆动
- 自碰撞:-1.0,避免腿部撞击机身
动作变化惩罚从 -0.1 逐步增加到 -1.0。前期保留步态探索空间,形成基本运动后再提高动作平滑性。
域随机化覆盖足底摩擦、质量、惯量、关节摩擦、编码器偏置、IMU 安装误差和外部速度扰动。
9.4 PPO 参数
- 并行环境数:4096
- 每环境每轮步数:24
- 正式训练轮数:5000
- 总仿真步数:491,520,000
- Actor 隐层:512、256、128
- Critic 隐层:512、256、128
- 激活函数:ELU
- 初始动作标准差:1.0
- 学习率:0.001,自适应
- PPO 裁剪范围:0.2
- 熵系数:0.01
- 折扣因子:0.99
- GAE 参数:0.95
- 目标 KL:0.01
- 每轮学习次数:5
- mini batch 数:4
- checkpoint 间隔:250 轮
- 随机种子:42
4096 个环境每轮产生 98,304 个控制样本。
4096 × 24 = 98,304
98,304 × 5000 = 491,520,000
任务配置的默认训练长度为 50000 轮。我们在训练命令中显式设置 5000 轮,并从训练后半段的 checkpoint 中选择最终模型。
9.5 执行计划
正式训练分为三个阶段。
- 冒烟训练:64 环境,5 轮;验证任务注册、CUDA、日志和 checkpoint 写入
- 容量测试:4096 环境,200 轮;验证显存占用、训练吞吐和数值稳定性
- 正式训练:4096 环境,5000 轮;生成可评测的行走 checkpoint
正式训练不应直接把最后一个 checkpoint 当作最终产物。训练完成后应比较 model_3000.pt、model_3500.p、model_4000.pt、model_4500.pt 和 model_5000.pt,使用相同的静止、直行、侧移、转向和停止测试选择模型。
后续命令以 model_4000.pt 为例,导出文件名为 model_4000.onnx。
10. 开始训练
10.1 配置 W&B
W&B 是训练记录工具,可以跟 AI 了解一下。
它会收集奖励曲线、训练速度、配置和运行状态,让你不必一直盯着终端。但不会参与物理仿真或 PPO 计算。
第一次使用时登录一次。
cd /root/autodl-tmp/microduck_rl
export UV_CACHE_DIR=/root/autodl-tmp/uv-cache
uv run wandb login
命令会等待你粘贴 API key,不要把 key 写进脚本或 Git。
训练时使用离线模式更稳妥。所有记录先保存在服务器,任务结束后再统一上传。
export WANDB_MODE=offline10.2 冒烟训练
这一步主要看进程能否正常结束。终端中应出现迭代信息,不应出现 CUDA OOM、NaN 或 Python traceback。
10.3 容量测试
本次容量测试完成了 19,660,800 个仿真步,用时约 4 分 45 秒,末段吞吐约为每秒 69,785 步。活跃期显存约 5.39 GiB,峰值约 5.45 GiB。
容量测试的重点是稳定,不需要从 200 轮模型判断最终步态。
10.4 在 screen 中运行正式训练
SSH 断开不应该带走训练进程,所以使用 screen 保存终端会话。
screen -S md-walk进入 screen 后执行下面的命令。
按 Ctrl+A,再按 D,可以离开 screen。进程会继续运行。
需要回到训练终端时使用。
screen -r md-walk11. 训练过程观察
另开一个 SSH 窗口查看日志。
tail -f /root/autodl-tmp/backups/baseline-flat-4090.log观察 GPU。
watch -n 2 nvidia-smi11.1 需要关注的指标
- Mean reward:所有奖励与代价的综合结果,适合看长期趋势
- Episode length:机器人能保持多久,逐渐增长通常意味着更稳定
- 速度跟踪奖励:命令速度和实际速度的接近程度
- Upright:身体是否保持竖直
- Air time:是否形成合理的抬脚和换步
- Action rate:相邻动作变化是否平滑
- Entropy:探索强度,通常会随训练逐步下降
- KL:新旧策略变化大小,影响自适应学习率
- nan_state:数值异常计数,必须保持为 0
曲线不会一直平滑上升。命令课程扩大、随机化增强或站立样本增加时,平均奖励可能下降。
值得关注的是数百轮范围内的趋势,以及机器人在固定评测场景中的实际表现。
日志中的 penalty 项按照负奖励记录,正常值应为 0 或负数。若某个 penalty 长时间变成正数,需要检查符号或日志定义。
11.2 本次正式训练结果
- 训练轮数:5000
- 并行环境:4096
- 总仿真步数:491,520,000
- 用时:1 小时 59 分 52 秒
- 训练结束状态:0
- nan_state:0
训练完成后检查退出状态。
cat /root/autodl-tmp/backups/baseline-flat-4090.status输出 0 表示命令正常结束。状态文件不存在时,训练可能还在运行,也可能终端在写入状态之前被中断,此时结合 screen -ls 和进程列表判断。
11.3 同步 W&B
找出离线 run 目录。
find /root/autodl-tmp/microduck_rl -type d -name 'offline-run-*'把找到的实际目录交给同步命令。
cd /root/autodl-tmp/microduck_rl
uv run wandb sync /实际路径/offline-run-时间与编号
同步只上传曲线和记录,不会改变训练结果。即使暂时不使用 W&B,本地 checkpoint 和日志仍然完整可用。
12. checkpoint 横向选择
训练结束时会得到一串文件。
model_250.pt
model_500.pt
model_750.pt
...
model_4750.pt
model_4999.pt
它们是策略在不同训练阶段的快照。强化学习的最后一轮不天然优于前面的所有轮次。平均奖励是多个目标的加权结果,也无法完全代替我们真正关心的场景测试。
本次保留了 2500、3500、4000、4500、4750 和 4999 等候选,使用相同随机种子、相同速度命令和相同持续时间进行横向检查,最终选择 model_4000.pt。
12.1 建议的评测矩阵
- 静止站立:命令全部为 0,观察是否原地踏步、摇晃或倒下
- 低速前进:命令 0.2 m/s,观察启动是否平顺,速度是否接近命令
- 正常前进:命令 0.3 m/s,观察持续稳定性和步态质量
- 后退:命令 -0.2 m/s,观察是否能真正向后移动
- 左右转向:命令正负 0.5 rad/s,观察转向方向、角速度和足底滑动
- 停止:从运动切换到 0,观察能否收住动作并站稳
- 扰动:外部速度推扰,观察是否自行稳住或进入恢复
批量评测最好使用 256 个或更多环境,并固定 seed。视觉上好看的一次运行只能说明策略有可能成功,批量成功率才能反映它是否稳定。
也可以先用训练框架的 viewer 查看某个 checkpoint。
如果当前 play 版本使用不同参数名,以 uv run play Mjlab-Velocity-Flat-MicroDuck --help 的输出为准。checkpoint 选择的评测条件应保持不变,不要一边换模型一边换速度或地面参数。
13. 导出 ONNX
13.1 checkpoint 和 ONNX 的区别
- .pt:继续训练、恢复优化器、在训练框架中评测
- .onnx:CPU 推理、MuJoCo 独立仿真、机器人运行时部署
Actor 在训练时使用观测归一化。原始角速度、关节速度和控制命令的数值尺度不同,归一化会让网络更容易学习。导出时必须把这层一起放入 ONNX,否则同一组观测会经过错误的尺度进入网络。
项目中的 scripts/export.py 会自动完成这件事,所以不要自行拼接 torch.onnx.export。
13.2 执行导出
日志中出现 Written 和目标路径后,ONNX 已经生成。
13.3 检查接口和数值
cd /root/autodl-tmp/microduck_rl

uv run python - <<'PY'
import numpy as np
import onnxruntime as ort

path = "/root/autodl-tmp/artifacts/baseline-flat-4090/model_4000.onnx"
session = ort.InferenceSession(path, providers=["CPUExecutionProvider"])
input_meta = session.get_inputs()[0]
output_meta = session.get_outputs()[0]

print("input", input_meta.name, input_meta.shape)
print("output", output_meta.name, output_meta.shape)

obs = np.zeros((1, 61), dtype=np.float32)
action = session.run(None, {input_meta.name: obs})[0]
print("finite", np.isfinite(action).all())

assert input_meta.shape[-1] == 61
assert output_meta.shape[-1] == 14
assert np.isfinite(action).all()
PY
预期输入形状为 [1, 61],输出形状为 [1, 14],有限值检查为 True。
零观测不是一个真实的机器人状态,这项测试也不评判动作好坏。它只是快速确认模型接口正确,并且前向计算没有 NaN 或无穷值。
14. 模型下载
在 Mac 上建立归档目录。
PROJECT_ROOT="$HOME/projects/microduck"
mkdir -p "$PROJECT_ROOT/artifacts/baseline-flat-4090"
填入当前云服务器连接信息。
建议同时下载训练日志、配置文件和 W&B 离线目录,模型出现问题时会更容易追溯。
15. 启动策略仿真
15.1 快捷键配置
仿真操作的快捷键需要我们自己定义和配置。MuJoCo viewer 会把键盘代码传给回调函数,机器人速度命令、复位和暂停等行为都由 scripts/infer_policy.py 实现。
脚本开头定义了 WALKING_VIEWER_KEYMAP。这里只使用 passive viewer 中没有被占用的方向键、数字 6 和 7、F10 到 F12,避开字母键、数字 0 到 5 以及 F1 到 F7 的内置功能。
WALKING_VIEWER_KEYMAP = {
    265: "up",       # 方向键上,前进
    264: "down",     # 方向键下,后退
    263: "left",     # 方向键左,左转
    262: "right",    # 方向键右,右转
    ord("6"): "6",  # 向左侧移
    ord("7"): "7",  # 向右侧移
    32: " ",         # 空格,速度命令清零
    299: "i",        # F10,直立复位并暂停
    300: "t",        # F11,暂停或继续
    301: "q",        # F12,退出
}
viewer 创建时通过 key_callback 接收按键。回调只接受上表中的键值,再把对应动作送入仿真循环。
viewer_key_events = queue.SimpleQueue()

def viewer_key_callback(keycode):
    key = WALKING_VIEWER_KEYMAP.get(keycode)
    if key is not None:
        viewer_key_events.put(key)

with mujoco.viewer.launch_passive(
    model,
    data,
    key_callback=viewer_key_callback,
    show_left_ui=False,
    show_right_ui=False,
) as viewer:
    ...
仿真循环中的 handle_key() 再把 up、down、left、right、6、7 等符号转换成 lin_vel_x、lin_vel_y 和 ang_vel_z。因此,修改快捷键时只需调整映射表,修改某个按键的控制行为时才需要修改 handle_key()。
配置完成后可以先做语法检查。
cd "$PROJECT_ROOT/microduck_rl"
uv run python -c 'compile(open("scripts/infer_policy.py").read(), "scripts/infer_policy.py", "exec")'
15.2 启动仿真
模型下载完成后,使用仓库自带的 scripts/infer_policy.py 加载行走 ONNX。
命令中提供 --walking,整个仿真过程始终调用同一个策略。零速度站立、前进、后退、侧移和转向都由这张 ONNX 完成。
--new-cmd-obs 表示使用当前的 13 维命令区。速度命令 3 维、头部姿态命令 4 维、身体姿态预留 6 维,再加上状态观测后形成 61 维输入。缺少这个参数会造成策略输入布局不一致。
macOS 原生 MuJoCo viewer 需要由 mjpython 启动。普通 python 适合无窗口检查,不适合启动原生 viewer。
启动后先观察低速前进。终端每秒输出一次命令速度、实际速度和躯干高度,可用于判断策略是否跟随命令。
16. 场景测试
启动仿真后先点击 MuJoCo 窗口,让 viewer 获得键盘焦点。
- 方向键上:设置前进命令
- 方向键下:设置后退命令
- 方向键左:设置左转命令
- 方向键右:设置右转命令
- 6:设置向左侧移
- 7:设置向右侧移
- 空格:将三个速度命令清零
- F10:重置为直立姿态并暂停推理
- F11:暂停或继续策略推理
- F12:退出
部分 Mac 键盘需要按住 Fn 才会发送标准的 F10 到 F12。按 F10 后策略处于暂停状态,需要再按一次 F11 才会继续运行。
建议按固定顺序完成交互测试:
- 以 --lin-vel-x 0.10 启动,观察 10 秒低速前进
- 按空格,观察能否减速并保持站立
- 测试后退和左右侧移
- 测试左右原地转向
- 同时设置前进和转向,观察弧线行走
- 按 F10 复位,再按 F11 检查重新启动是否正常
需要可重复的测试条件时,直接使用命令行参数,不依赖手动按键。
使用 --save-csv 可以保存每个控制周期的观测和动作。
17. 验收标准
模型验收按文件、接口、数值、时序和运动表现逐层进行。每一层都只针对这一张行走策略。
- 文件层:SHA-256,云端和 Mac 完全一致
- 接口层:ONNX 输入输出,输入 61 维,输出 14 维
- 数值层:ONNX 前向计算,动作全部为有限值
- 时序层:运行频率,50 Hz 持续运行,无明显卡顿
- 静止层:零速度命令,能够站立,不持续漂移或高频踏步
- 直行层:前进和后退,命令方向正确,动作连续
- 侧移层:左右速度命令,两个方向都能响应,没有明显单侧失稳
- 转向层:左右角速度命令,能够原地转向和弧线行走
- 停止层:运动命令归零,能够减速并重新站稳
- 回归层:Python 与 Rust 测试,全部通过或只有已知的平台跳过项
建议使用固定测试序列比较不同 checkpoint:
静止 5 秒
前进 10 秒
静止 5 秒
后退 8 秒
左侧移 8 秒
右侧移 8 秒
左转 8 秒
右转 8 秒
弧线行走 10 秒
静止 5 秒
每个候选模型使用相同的初始姿态、命令和测试时长。记录实际速度、是否跌倒、停止距离、躯干高度、明显偏航和动作抖动。
训练总奖励只能说明优化过程,不足以代替运动验收。最终 checkpoint 应由固定场景的横向比较决定。
18. 从仿真走向实机
到这里,行走策略已经完成训练、导出、CPU 推理和单策略场景验收。仿真能够排除大量软件和接口问题,但不能证明真实机器人一定安全。
机器人到货后建议按下面的顺序验证。
- 在卸载或悬空条件下确认舵机 ID、方向和通信
- 检查 14 个关节的零位、默认姿态和机械限位
- 对照训练模型确认关节顺序和正负方向
- 电机未使能时采集 IMU、关节位置和关节速度,核对 61 维观测
- 在吊架和低增益保护下发送标准关节姿态
- 加载行走 ONNX,保持三个速度命令为零
- 使用外层限幅逐步开放动作范围和电流
- 从极低速前进开始,依次验证停止、后退、侧移和转向
- 记录实机 IMU、关节状态、策略动作和电机反馈,与仿真 CSV 对比
- 确认低速稳定后再逐步扩大速度范围
实机测试区域应铺设软垫,并准备独立的急停或断电方式。观测顺序、关节方向、默认姿态、动作缩放、控制频率和电流限制全部确认之前,不应执行无保护行走。
19. 常见问题
18.1 MuJoCo 窗口没有出现
Mac 上确认使用 uv run mjpython。原生 viewer 需要在 macOS 主线程中运行,普通 Python 启动方式可能只能完成计算,无法正常显示窗口。
18.2 窗口出现但按键无效
先点击 MuJoCo 仿真画面,让 viewer 获得键盘焦点。方向键和数字 6、7 可以直接测试。
功能键无响应时按住 Fn 再按 F10、F11 或 F12。按 F10 复位后策略会自动暂停,需要按 F11 恢复推理。
18.3 ONNX 能加载,动作却明显不对
按顺序核对这些项目。
- 输入宽度为 61,输出宽度为 14
- 启动命令包含 --new-cmd-obs
- 使用当前仓库的 scripts/export.py
- 训练、导出和仿真使用相同的 Git commit
- action_scale 保持为 1.0
- 使用投影重力,不添加 --raw-accelerometer
- 模型 SHA-256 与归档记录一致
18.4 训练监控中看不到进程
screen -ls
screen -r md-walk
ps aux | grep '[t]rain Mjlab-Velocity-Flat-MicroDuck'
训练已经结束时,读取状态文件。输出 0 表示正常完成。
cat /root/autodl-tmp/backups/baseline-flat-4090.status18.5 GPU 几乎没有负载
确认当前虚拟环境中的 PyTorch 能看到 CUDA。
cd /root/autodl-tmp/microduck_rl
export UV_CACHE_DIR=/root/autodl-tmp/uv-cache

uv run python -c 'import torch; print(torch.cuda.is_available()); print(torch.cuda.get_device_name(0))'
第一行应为 True。如果显示 False,应检查虚拟环境中的 PyTorch 构建版本。

本文提及与引用
原文提到的内容里,已在本站整理好的可以直接接着读;标注「原文来源」的还没有整理成站内文章。
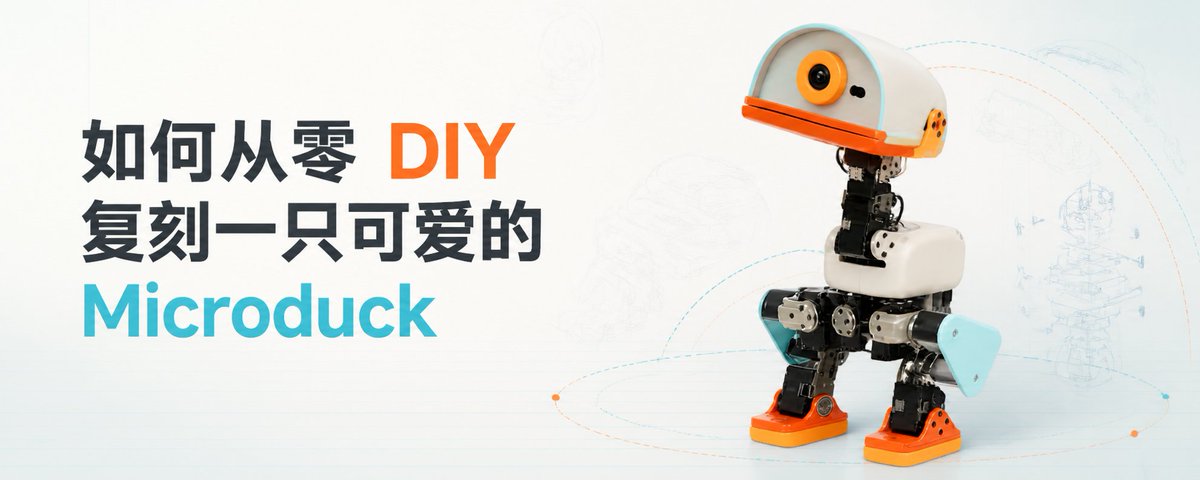
- 如何从零 DIY 复刻一只可爱的 Microduck内嵌推文 · 站内已整理 · 这是一份 Microduck 小型双足机器人的 DIY 复刻指南。它先说明整机结构与控制链路(15 个 Dynamixel 舵机、其中 14 个
内容核验说明
这份记录把一条完整工程链路摊开:仓库分工、PPO 参数、域随机化范围、checkpoint 横向选择、ONNX 接口校验,一直到实机检查顺序,都有具体数值和命令可对照执行。适合做足式机器人 sim-to-real、想要一份可复现流程的工程师。训练耗时、显存、吞吐等数据来自作者公开披露,诀.com 未独立验证,照做也未必复现同样结果。
文中的数据(训练用时约 2 小时、显存 5.39/5.45 GiB、吞吐约 69,785 步每秒、166 项测试通过等)均来自作者公开披露,诀.com 未独立验证;配置流程、参数与验收结论未经本站实测,结果不保证复现。评论区整合
根据评论整合来看,讨论集中在两处:有读者认同双足加头部带来的重心、接触、舵机和姿态耦合,手写规则容易漏场景,这种说法比空喊强化学习更先进更有说服力;也有人追问细节,比如项目叫 micro duck 而尺寸接近普通鸭子,以及流程里 Rust 具体用在哪。另有读者反馈内容看不到。评论量少,没有形成明确共识,也没出现对技术方案的质疑。
基于原帖公开评论整理,只反映讨论中的观点与反馈,不代表诀.com 立场。原始来源
原作者:yishan(@tspy)
本文对公开来源内容进行了结构化整理,原观点与内容归原作者所有。
查看原文