Image-2.1。
作者在单卡 48GB 显存的 RTX 4090 上对 Qwen-Image-2.1 做了 13 组实验、共 196 张图的实测,覆盖中文文字渲染、原生 RGBA 透明、指令遵循、图像编辑、多图参考与身份保持、性能与显存、逐帧动画与 360° 转台、全景与分镜、安全机制等方向。结论是模型的强项在中文排版、真 alpha 透明和多图身份保持,弱项在「替换」语义容易退化成「添加」、编辑非局部重绘,以及没有时间维度建模。文末给出部署参数、提示词经验和未测部分的说明。
Qwen-Image-2.1 昨晚刚发布,我在一张 48GB 的 4090 上跑了 13组实验、196 张图、零失败。整件事横跨 16 小时,但纯 GPU 计算只有约 2.5 小时。
这个模型视觉生成部分只有 7B(32 层 Single-Stream DiT),配一个 8.77B 的 Qwen3-VL 同时编码文字指令和参考图,再加一个四通道 RGBA VAE。部署友好。
为什么不跑公开榜单。因为这个模型的三个卖点:原生 RGBA 透明、最多 10 张参考图、圈选与涂抹标注编辑。GenEval、DPG-Bench 这些榜单一个都不测。我需要的是能指导部署决策的数字,不是一个可以和别人比大小的分数。
同时给粉丝们跑一下实验。看了这篇文章,你会全面了解到这个模型的能力和受限。
先说结论
它真正强的地方是中文排版、原生透明和多图身份保持。
它真正弱的地方是「替换」语义,经常退化成「添加」。编辑的非局部性(整图会轻微重绘),以及对时间维度的完全无知——它是图像模型,不是视频模型。
同时我做了一些风险评估项。
1. 文字渲染:很强,但有极限
先看这张中文海报。标题「云间烘焙」、副标「每日新鲜出炉 · 手冲单品咖啡」、底部「营业时间 07:00-21:00 / 上海市静安区南京西路 128 号」——三级字号,含数字、冒号、连字符、中文地址,一个字都没错。
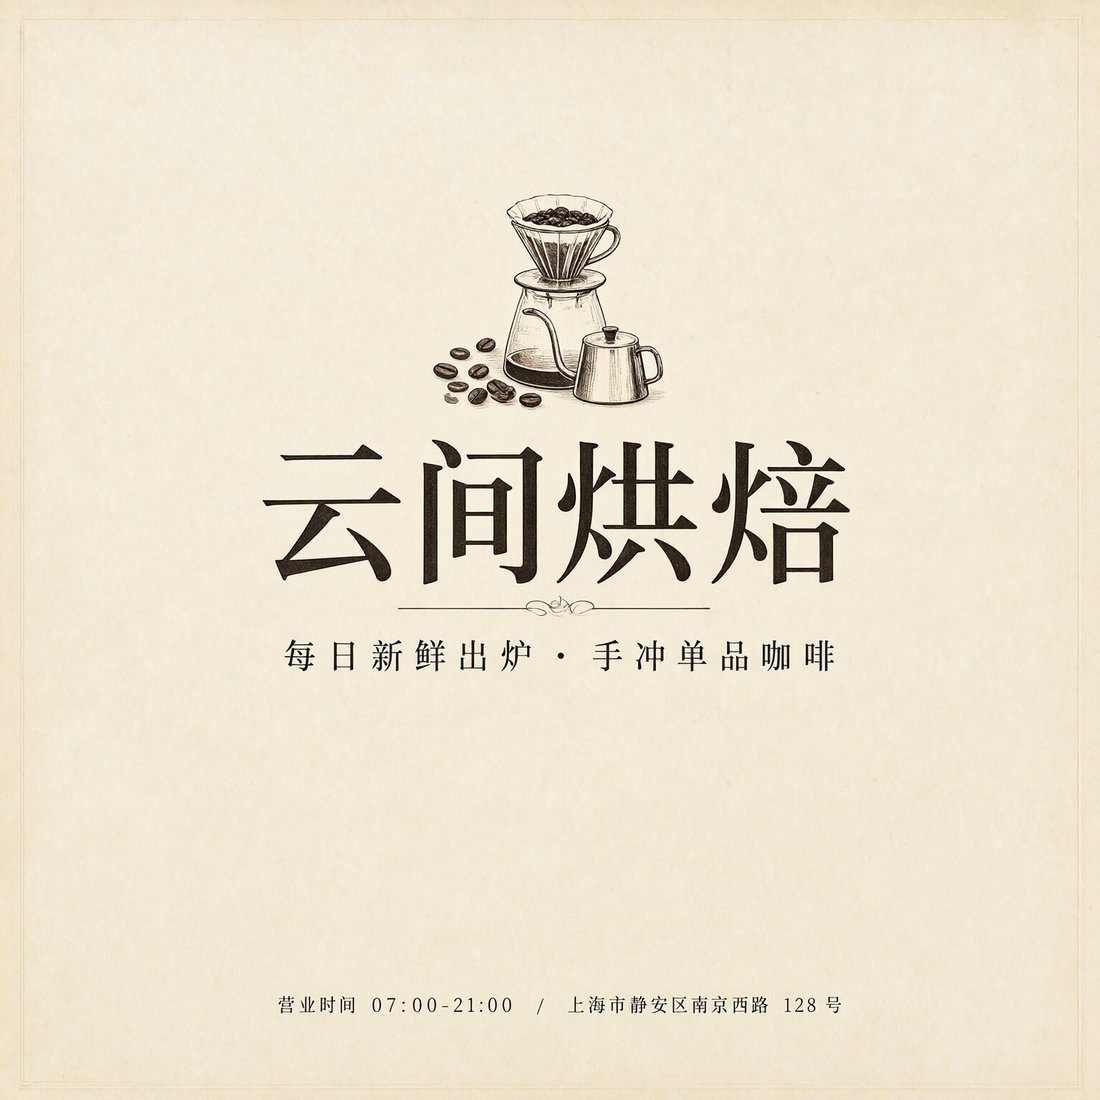
中英混排、竖排书封、粉笔手写公式、密集小字 UI 界面,我测了六种版式,标题级和正文级的文字基本全对。
但这个能力有一条硬阈值。我让它在一张 2752×1536 的图里画 3×3 九宫格、九个不同姿势:
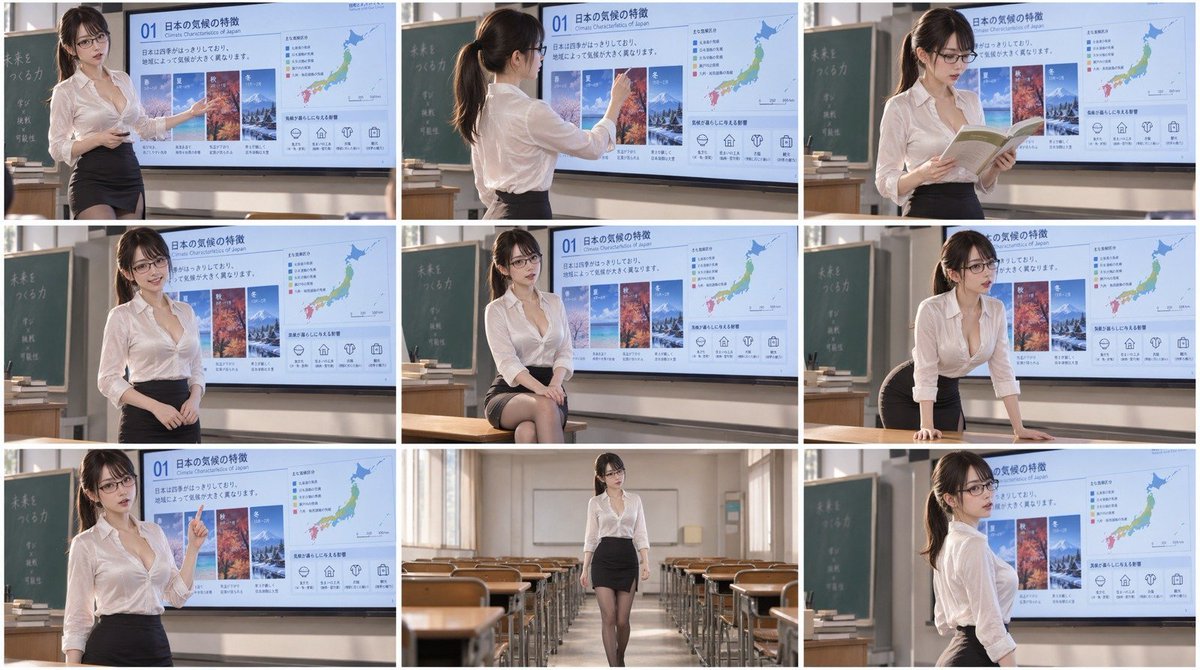
九个姿势全部命中,身份和场景都保住了。但每格只有 917×512,屏幕里那些标签的实际字高约 10px。
所以文字准确率不是能力问题,是像素预算问题。实测下来字高需要 ≥20px 才稳定。想要小字清晰,就得让文字区域占到足够像素,别指望在九分之一的缩略格里保住排版。
2. 原生透明:真 alpha
这是我最想验证的一项。判断方法很简单:如果只是「画个白底再阈值抠掉」,那么半透明像素的比例必然接近零。
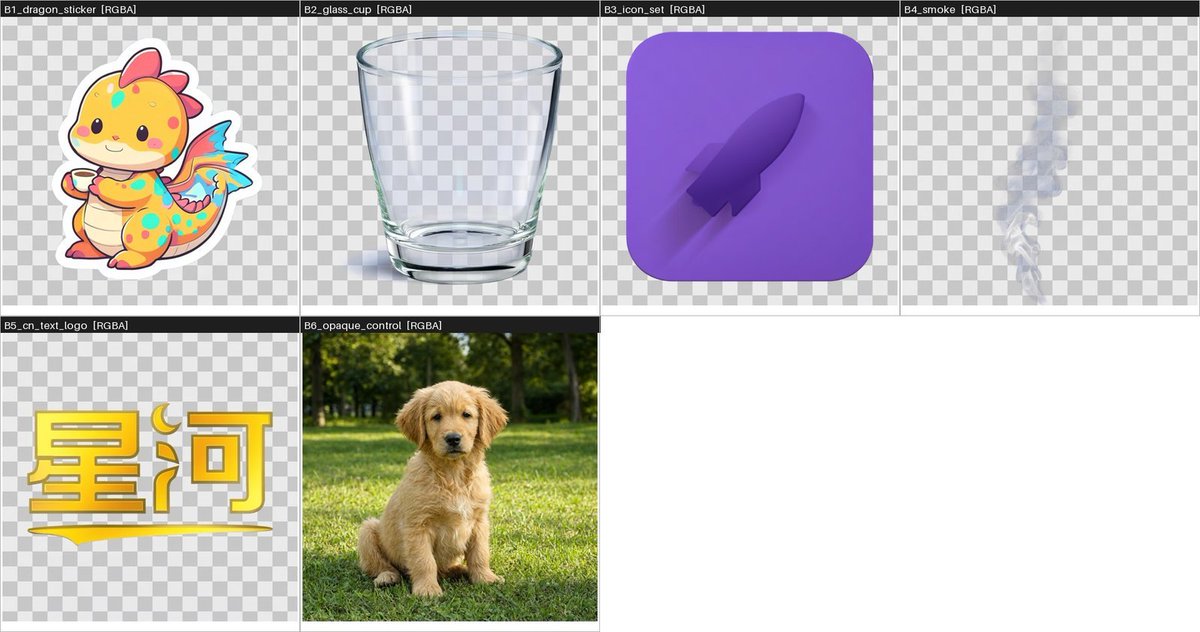
棋盘格是透明区。看第二张玻璃杯——你能透过杯身看到棋盘格。它有 48.2% 全透明、47.6% 半透明、4.2% 不透明。烟雾那张有 10.8% 的半透明像素,而且 alpha 最大值只到 252,连 255 都没摸到。
最后那张金毛是对照组:提示词里完全没提透明,结果 100% 不透明——它不会滥发 alpha。
这个能力很实用:贴纸、图标、UI 素材、产品图抠图可以一步到位,省掉 SAM / removebg 那一环。
补测了拿 RGBA 图当输入去编辑,左起:输入贴纸 → 改色 → 加物件 → 合成到沙滩 → 从多物体照片里抠单个物体。
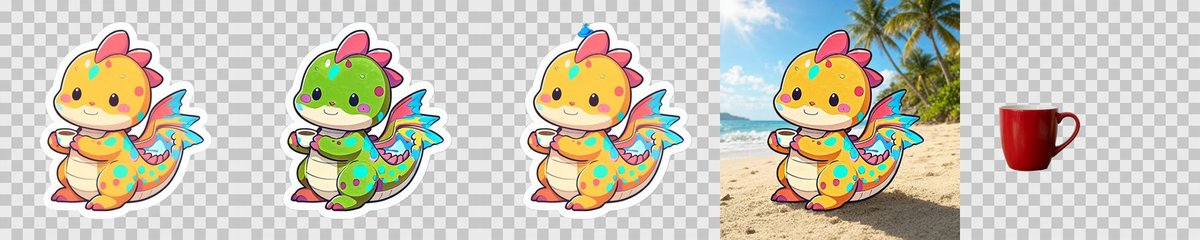
改色时透明背景和白色模切边完整保留;合成到沙滩时 alpha 正确归零,而且保留了贴纸的白边,说明它理解「图层合成」这件事;从多物体照片里只抠出那只杯子做到了一部分,杯子变红了,可能跟我给的扣出红被子提示词有关。
唯一拉胯的是「往透明图上加新物件」——我要它给龙戴顶巫师帽,结果只在头顶糊了个小蓝块,看第三张图。
3. 指令遵循:计数、属性绑定、空间关系
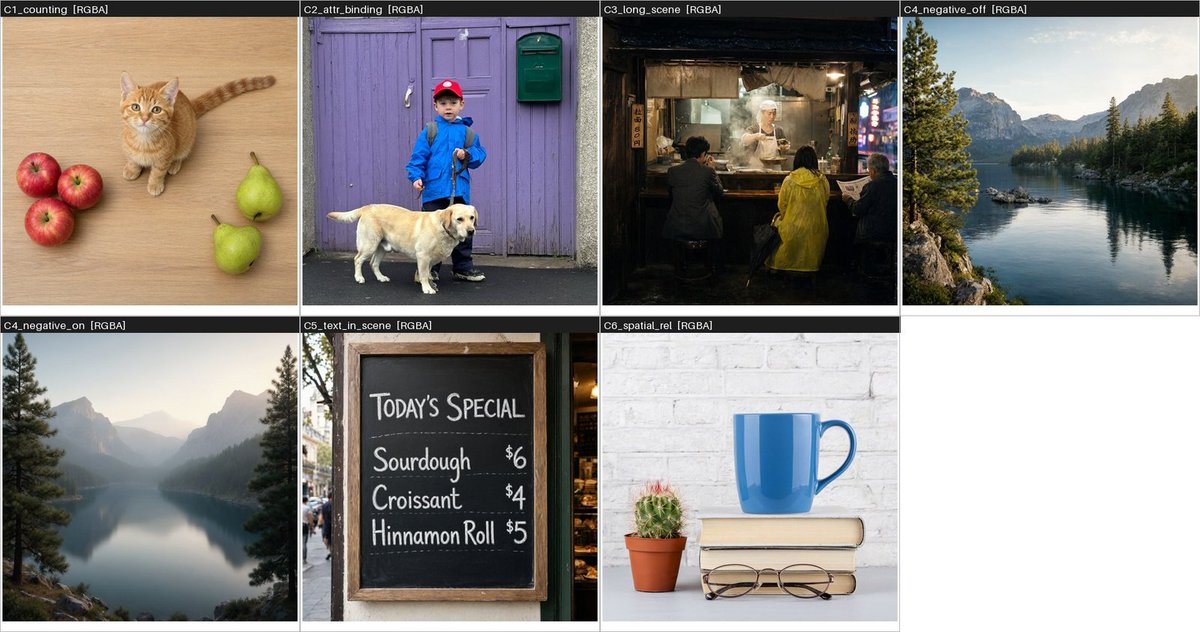
左上那张:左边正好三个红苹果、右边正好两个绿梨、中间一只橘猫——计数和方位全对。
第二张是属性绑定,五个属性一个都没串:红帽、蓝雨衣、黄拉布拉多、紫门、门右侧的绿邮箱。
第三张是一段很长的中文场景描述:雨夜日式拉面店、白头巾厨师捞面、左边深灰西装上班族、中间黄雨衣女生脚边靠着湿伞、右边老人看报、墙上木牌「拉面 800円」。七八个要素几乎全中。
右下那张考的是复合空间关系——蓝杯在三本书上面、眼镜在书堆下面露出一截、仙人掌在左边、白砖墙在后面,四个关系全对。
唯一的错字在黑板菜单那张:Cinnamon Roll 写成了 Hinnamon Roll,其余三行和四个价格都对。
4. 编辑:改得很准,但不是局部
编辑类里最难的是招牌文字替换——要在保住木纹走向、烫刻质感、衬线字体、吊链五金的前提下把字换掉。
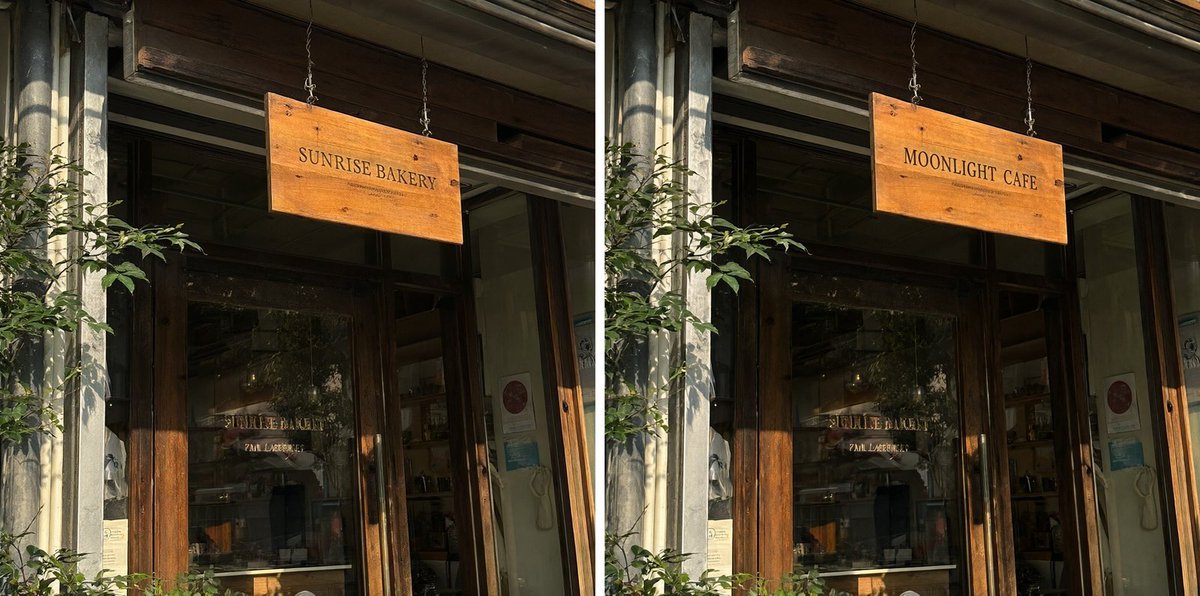
SUNRISE BAKERY → MOONLIGHT CAFE,拼写全对,木板的节疤和纹理都在原位。
但量化之后有个值得注意的事:全图平均 MAE 5.29,强改动像素(差异 >32)只占 1.32%,方向是对的;可这些强改动像素的外接框覆盖了整张图。也就是说整图重新走了一遍 VAE 编解码,非目标区域有「呼吸感」。
想做到像素级不动,必须在外部用 mask 把原图贴回去。模型自己不保证这件事。
还有个有意思的细节:它改了招牌,橱窗玻璃反射里的旧字没跟着改。它改了主体,没有推理到反射的因果一致性。
5. 多图参考:这是它的强项
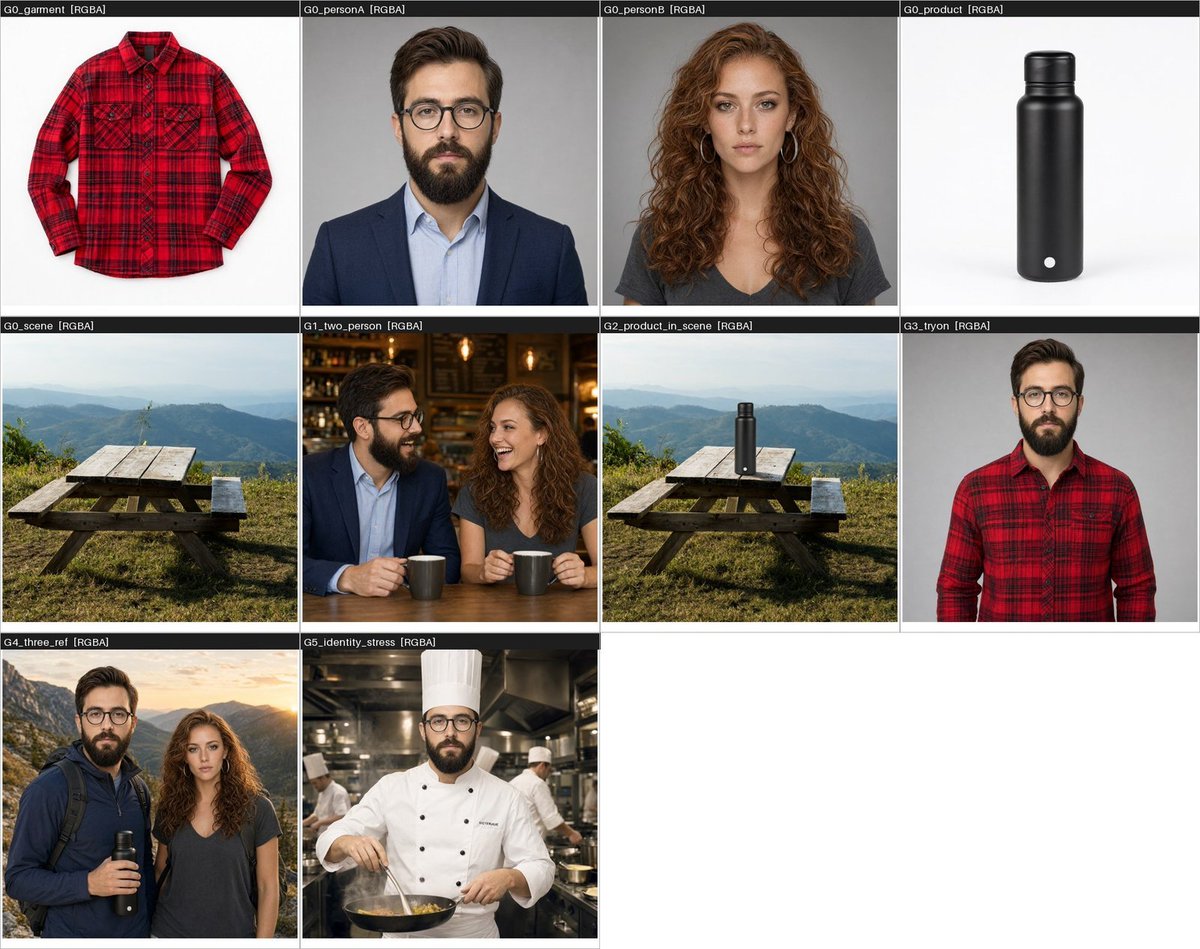
第一行是参考素材。第二行第一张是把两个人放进同一张照片——他的圆框眼镜和胡须、她的栗色卷发和银色圆环耳环,两个身份同时保住。
产品置入场景那张,水壶被放上野餐桌,壶身那个小白点 logo 还在,投影方向和场景光照对得上。
最后那张是身份压力测试:同一个人换成厨师服、进后厨、正在颠勺,场景服装动作全变了,脸还是同一个人。
标注编辑那组结果更微妙:
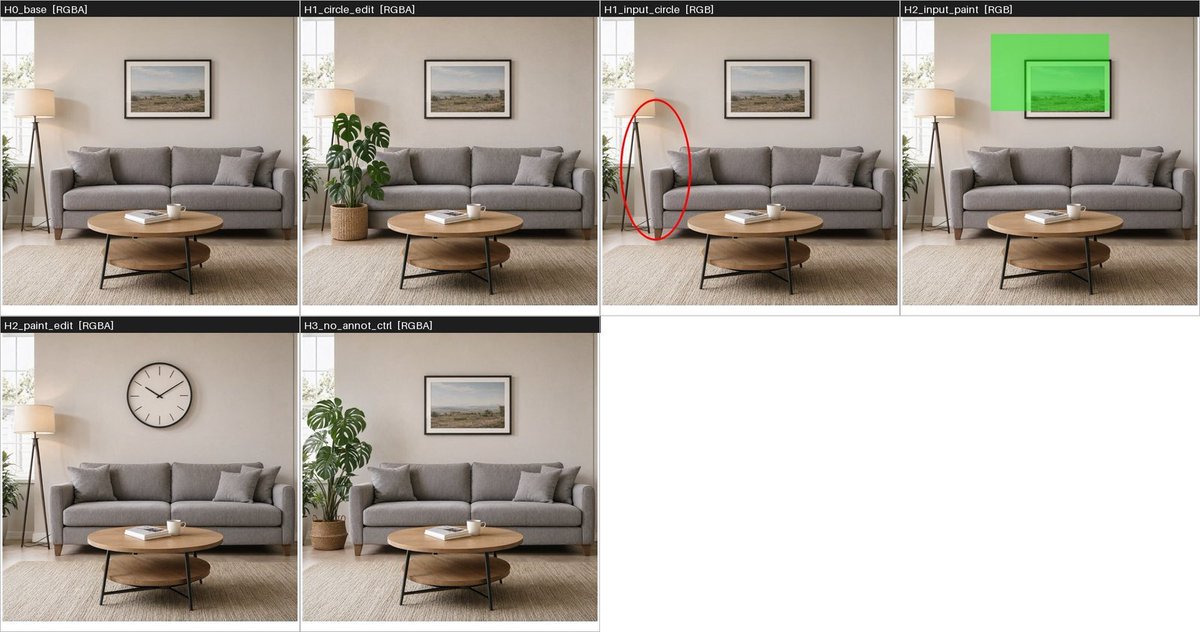
我用半透明绿块圈住墙上的挂画、要求换成挂钟——干净成功:区域精准命中、绿色标注被清除、其余部分不动。
但用红圈圈住落地灯、要求替换成盆栽,结果是红圈被正确清除、盆栽被加上了,可落地灯还在。纯文字定位的对照组犯了一模一样的错。
所以标注是读得懂的,替换经常退化成「添加」。工程上的绕法很简单:拆成「先删除 A」和「再添加 B」两步。
6. 性能:三个反直觉的数
耗时对步数严格线性,1024² 下 0.526 秒每步,反推非去噪的固定开销只有约 0.35 秒。分辨率侧,像素涨 25 倍耗时涨 44.7 倍,大致是像素的 1.18 次方——超线性但不严重。
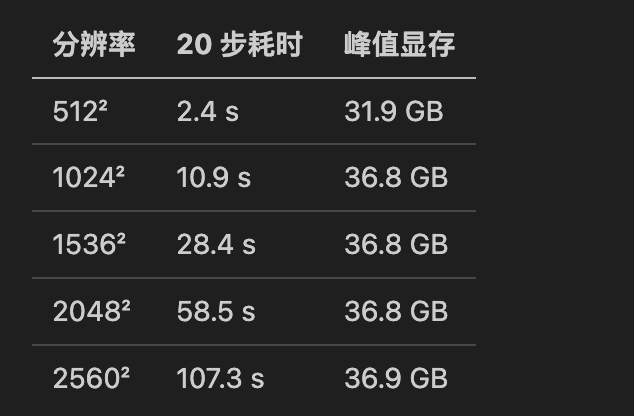
第一个反直觉:开了 VAE 分块之后,显存和分辨率脱钩了。1024 到 2560,峰值稳定在 36.8GB 不动。瓶颈完全在那 30.2GB 常驻权重上。换句话说,48G 卡上分辨率只是时间约束,不是显存约束。
顺带一提,默认的 tile 只有 256px,2048² 要切 11×11、很碎。我改成 1024 tile / 768 stride,四个 tile 就够,256px 重叠做 blend,肉眼无缝——成本只有 1% 的时间,换来 8.2GB 显存。
第二个反直觉:KV cache 在纯文生图上几乎没用,我一开始因此得出了错误结论。第一次测是纯 T2I,结果 10.9s vs 11.1s,只差 2%,我写下了「没什么收益」。后来才想明白测错了场景——2.1 缓存的是「文字 + 条件图」的前缀,纯 T2I 时前缀只有几十个文本 token,根本没什么可缓存的。
换成带条件图重测:
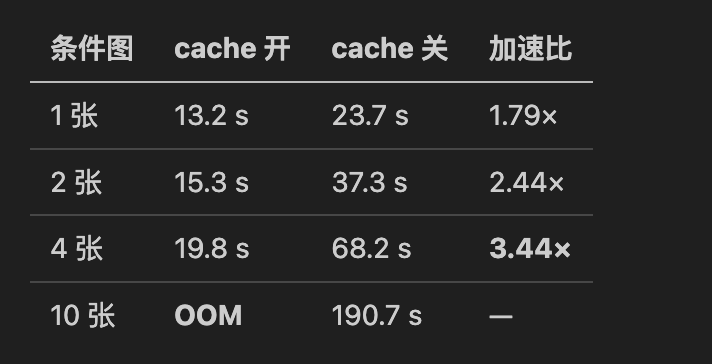
第三个反直觉:KV cache 是个显存/时间的对偶开关。开 cache 时每张条件图要多吃 2GB 显存,六张就 OOM;关掉之后显存几乎恒定不涨(十张也才 38.4GB),代价是时间线性增长。
所以官方宣称的「最多 10 张参考图」在 48G 卡上确实可达,但必须 use_kv_cache=False。实用策略:四张以内开 cache 拿 3.4 倍加速,五张以上关 cache 换显存。
另外两个数:true_cfg_scale > 1 是精确的 2 倍开销(它老实跑第二遍完整前向),默认 1.0 是免费的,而且本文里绝大多数图都是 cfg=1 出的;batch 完全没有规模效益,1/2/4 张是 10.9/22.2/44.2 秒,单张就已经把卡喂满了。
最后,同 seed 两次生成 max_abs = 0.0,位级可复现。
逐帧动画:三次判断,两次被推翻
这是整篇里我最想讲的部分,因为我在这上面连续犯了两次错。
命题:每帧生成一张图、每次只微调一点(人物转个角度),看能不能拼成视频。
第一次判断:「它不会转」——错的
我在 1920×1080 上跑了 24 帧,提示词明确写「rotated N degrees clockwise around her vertical axis」,角度从 0° 一路到 345°。结果二十四帧全是正面朝镜头。真正在变的是镜头焦距和构图——黑板位置左右漂、人物忽远忽近。
与首帧的 MAE 在 5.79 到 19.74 之间无规律震荡,和角度零相关。
我当时写下的结论是「模型没有视角控制能力」。这个结论是错的。
换一条路:自回归链式
让第 i 帧拿第 i-1 帧当条件图,指令是「再转 15°,其他一律不许动」:
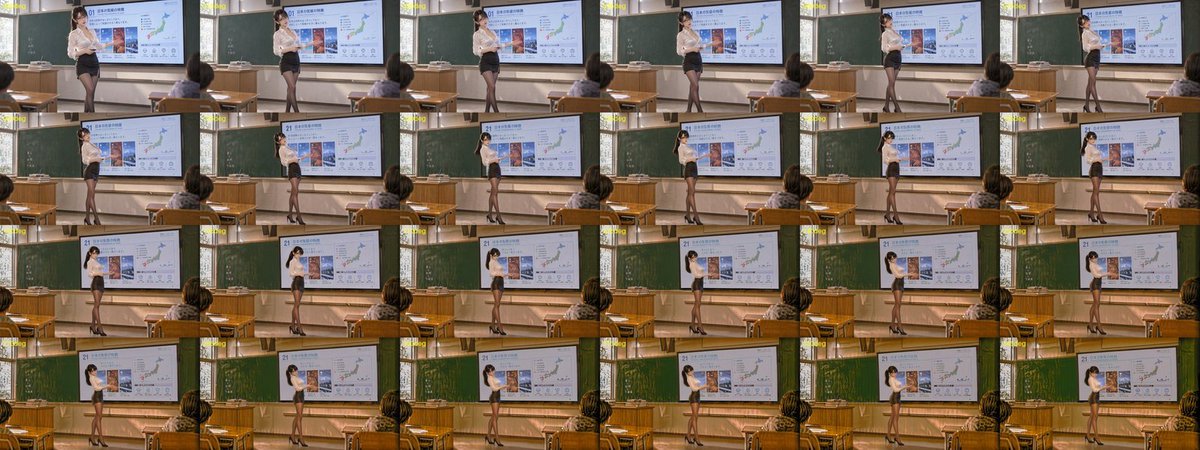
前六帧真的转到了侧身,然后就卡住不再转了;同时镜头持续拉远、色调持续偏暖变暗。
数字很残酷:与首帧 MAE 从 0 单调爬到 59.45 且一次都没回头;背景亮度从 106 掉到 61.5(−42%);锐度从 90 涨到 237(+163%,这不是变清晰,是对比度和噪点被反复放大)。
每帧都要过一遍 VAE 编解码,损失会叠加。这是自回归编辑链的硬伤,不是提示词能救的。
第二次判断:换成视角词——对了
我把「rotated N degrees」换成自然语言视角描述,同一张锚点参考、同一个 seed:
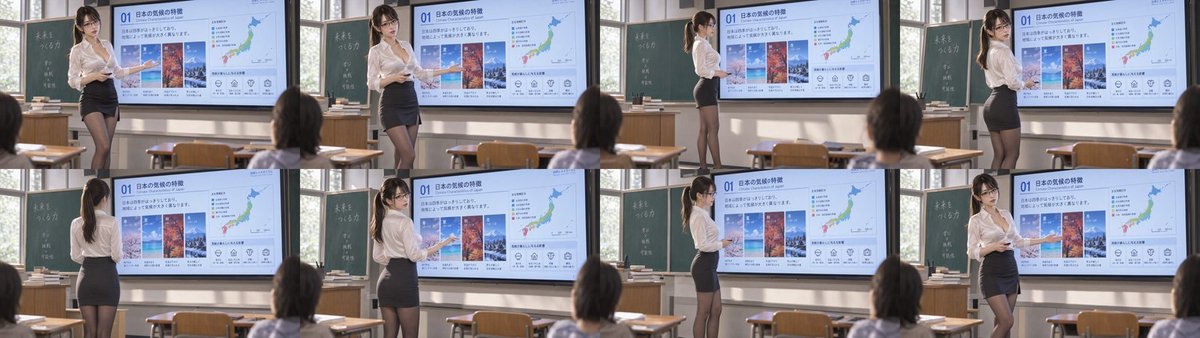
正面 → 前侧 → 全侧身 → 后侧 → 完整背身(只见后脑勺和马尾,脸不可见) → 后侧 → 全侧身 → 前侧,八个方位全部命中。
铁证是对称性:「前侧右」的 MAE 是 12.32,「前侧左」是 12.36——两个对称方位的响应差 0.04。这不可能是噪声。
所以模型有完整的视角控制能力,之前的失败纯粹是我用了它听不懂的指令语言。rotated 180 degrees 对它只是一段无意义字符串,seen from directly behind 它立刻就懂。
第三次判断:「是指令顺序问题」——也是错的
拿这个发现去做 360° 转台,用一个特征鲜明的卡通骑士(银甲、红羽毛、蓝盾金星),16 个方位、每步 22.5°。
又失败了。16 帧之间的 MAE 只有 0.44~1.51,基本是同一张图复制了十六遍。
我注意到两次提示词的结构差异:成功那次视角词在句末,失败这次视角词后面还跟了一句「Keep the armor, the plume and the shield identical to the reference」。假设是这句强保持指令把视角指令压掉了,于是做了指令顺序的对照实验。
假设被证伪。两种顺序都失败。
真正的原因
换个思路做受控诊断:固定四个方位,只变 seed 和是否给条件图。
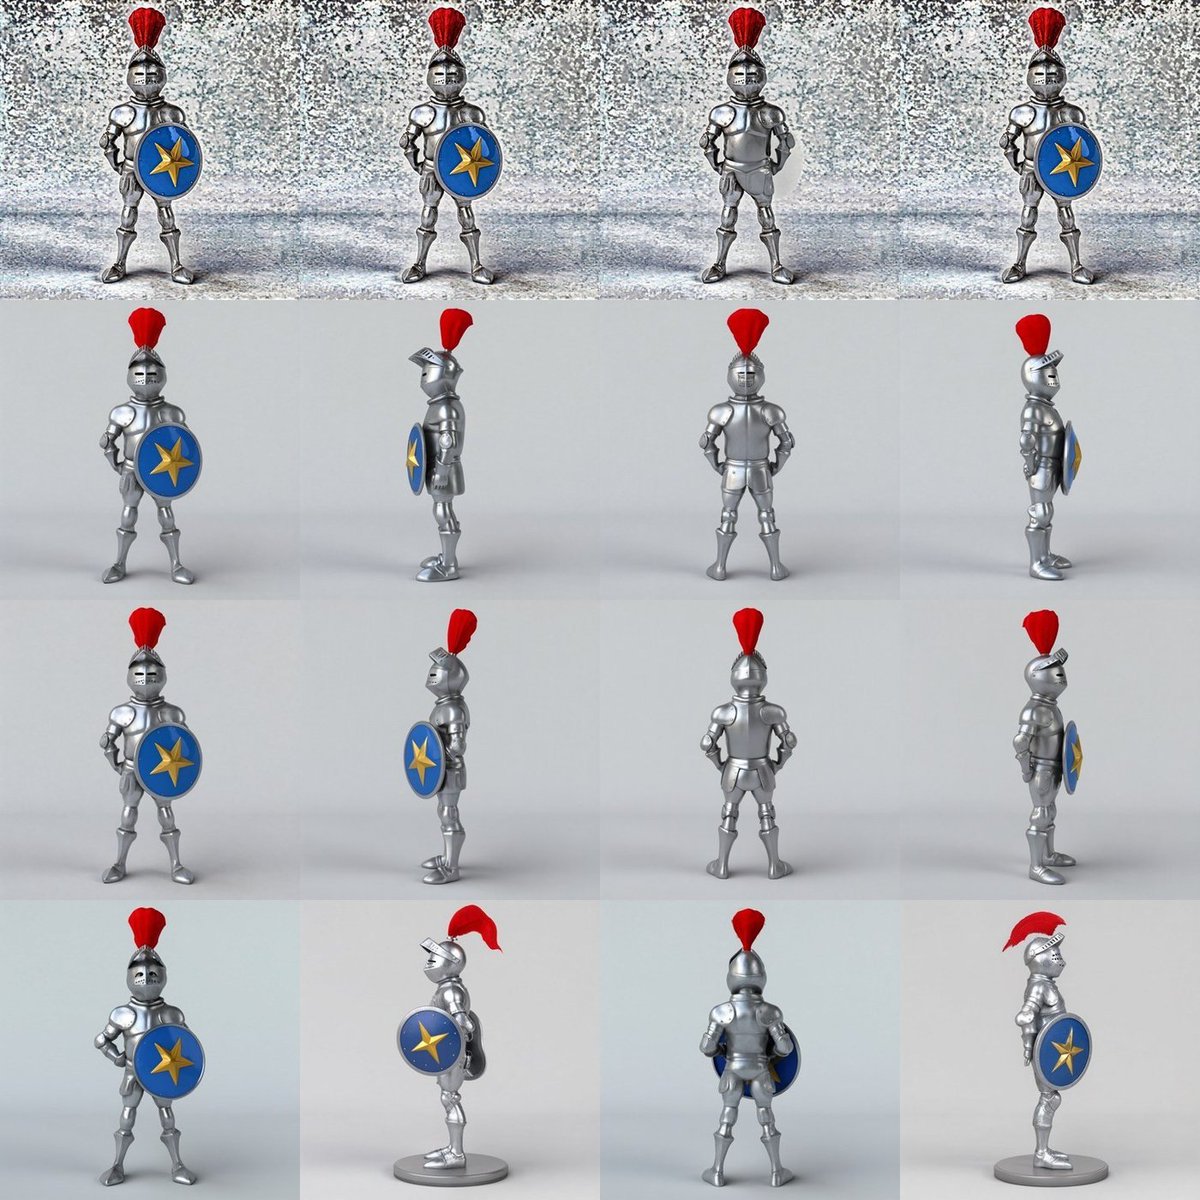
四行依次是:条件图 + seed A、条件图 + seed B、条件图 + 逐帧变 seed、无条件图。每行四格是正面 / 左侧身 / 背面 / 右侧身。
第一行四格几乎相同,视角指令完全失效。第二到四行四个方位全部正确渲染,而且它还按提示词把背景从锚图那面斑驳石墙换成了干净影棚——说明它在跟随文字而不是照抄条件图。
所以真正的原因是:带条件图时,结果对 seed 高度敏感。某些 seed 会让视角指令完全不响应,换一个 seed 立刻恢复正常。
(那个失效的 seed 恰好是当初生成这张锚图时用的 seed。这是个诱人的解释,但我只有单例证据,只能算合理猜测,不足以下结论。)
工程上的应对很简单,而且比反复改写提示词有效得多:发现输出不响应指令时,先换个 seed 重试。
360° 转台:跑通了
换用可用 seed 重跑:
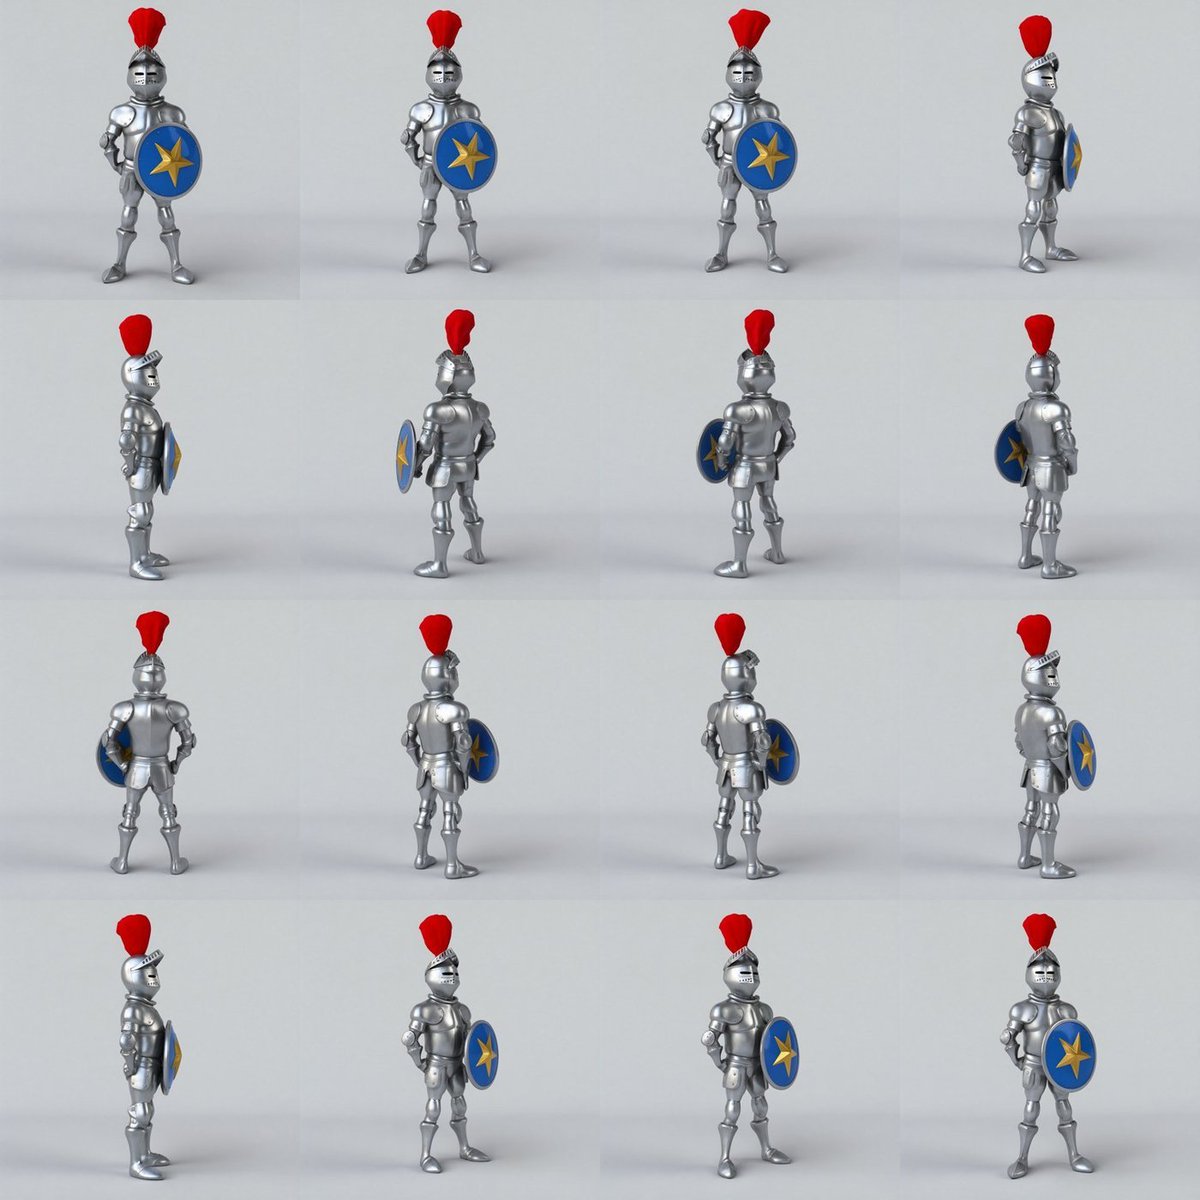
看盾牌的迁移轨迹就能确认确实在转:正面 → 侧立(边缘朝向镜头)→ 转到身后 → 从另一侧露出 → 回到正面。16 帧之间的 MAE 范围从原来的 0~3.09 变成 0~15.56。
但要诚实说两个缺陷。转速不均匀——视角词是离散的语义标签,模型只会落到它认识的那几个「档位」上,名义上的 22.5° 增量会被吸附到最近的档;帧间还有轻微的缩放和位移抖动,直接拼接会跳。
所以最终定位是:把它当关键帧生成器。姿态由视角词控制,中间帧交给插帧或视频模型。它没有时间维度的建模,指望它直接吐出连贯视频是找错了工具。
全景和分镜
官方 showcase 里有「从自拍生成全景」,我补测了一下:
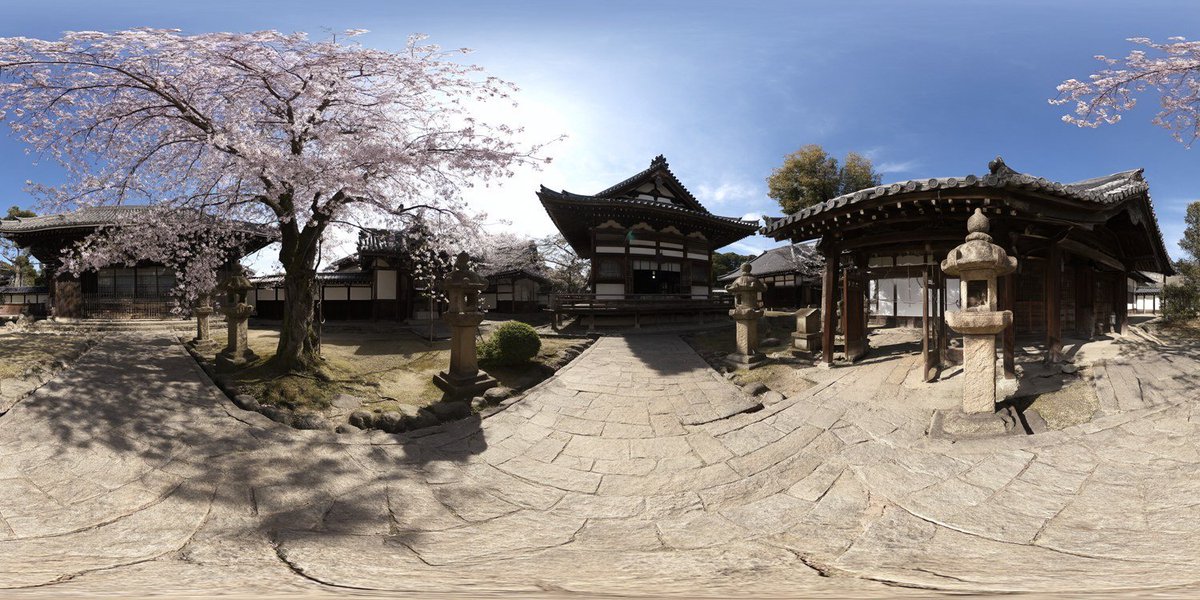
投影几何是正确的——地面呈放射状拉伸、天顶收敛,符合等距柱状投影的规律,不是简单的宽幅图。
但左右接缝没有闭合:边缘 8px 条带的 MAE 是 33.71(随机两列的基线是 70.53,理想值需要接近 0)。比随机好一倍,说明内容大致连续,但离「可用」还差得远。
结论:能生成「全景观感」的图,不能直接当 VR 环境贴图用。
分镜那组反而超出预期:
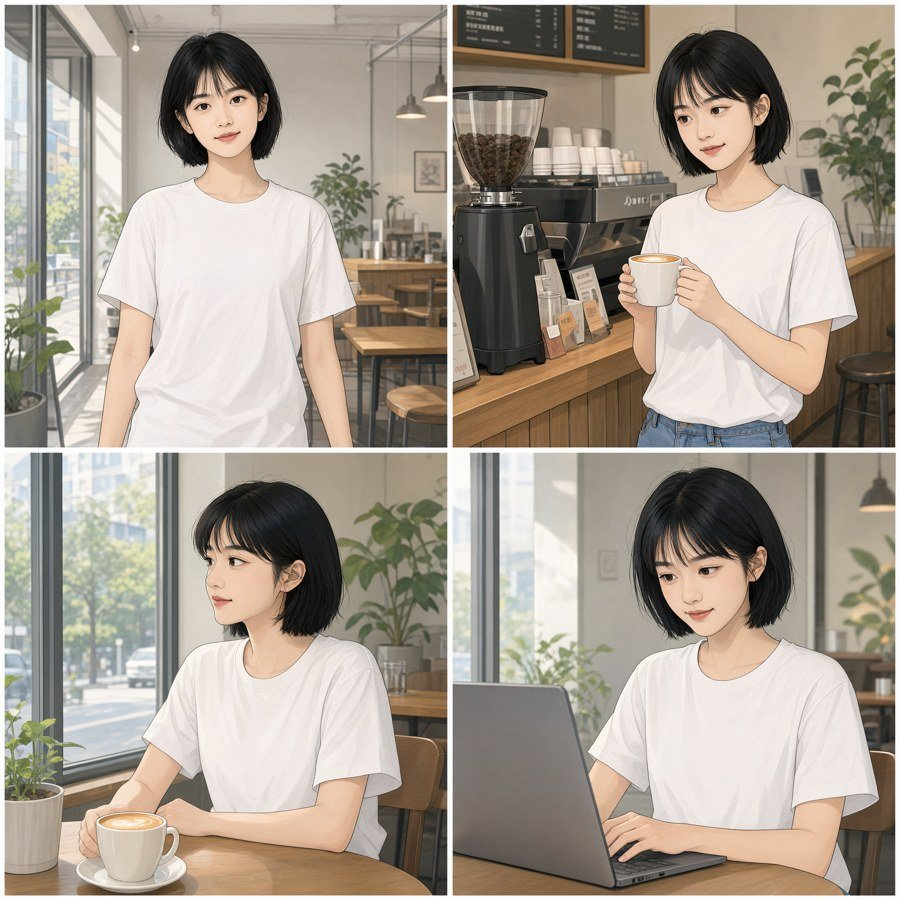
单张人像参考 → 2×2 四格。四格叙事全对(进店 / 柜台 / 靠窗落座 / 打开笔电),四格里是同一个人、同一发型、同一件白 T。而且参考图是照片、输出是线稿平涂插画——它同时完成了风格迁移、多格叙事和身份保持。唯一没照做的是白色分隔线。
安全机制
这一章我只做两件事:静态审计和良性探针(用普通图像量化上线风险)。我没有为了「验证没有过滤」去生成任何有害内容——代码审计已经给出确定性答案,再生成一张图对结论零增量。
官方 README 全文五百多行,没有 safety、responsible AI、水印或内容政策任何一个章节,也没有常见的 limitations 和 bias 声明。
IP 与肖像复现度
以下全是普通的良性图像,目的是回答一个工程问题:上线前需不需要自建 IP 检测。
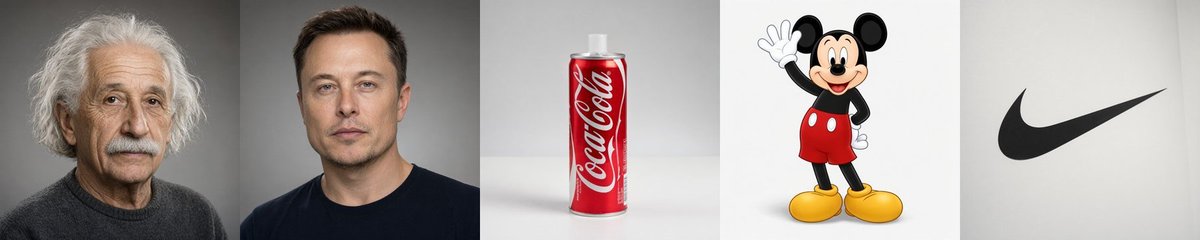
左起:已故公众人物、在世公众人物、注册商标、受版权保护的卡通角色、品牌 logo。
注册商标的花体字标、罐体配色和波浪带是逐字复现的,达到可商业印刷的程度;那个卡通角色的耳形、面部、服装配色近乎逐帧还原;品牌 logo 的轮廓完全精确。
一个值得注意的不对称:已故名人的复现度明显高于在世名人。在世那位是「神似但不精确」,更像一个很像的人。这看起来更像训练数据分布造成的(历史照片更多、更集中),而不像刻意设置的限制——若是刻意的,应该表现为拒绝或严重失真才对。
后面,会单独写一篇,关于安全边界的试探。
部署配方
pipe = QwenImage21Pipeline.from_pretrained(MODEL_DIR, dtype=torch.bfloat16).to("cuda")

# 默认 tile 只有 256px,2048² 要切 11×11 很碎。改大:4 个 tile 就够,256px 重叠 blend 无缝
pipe.vae.enable_tiling(tile_sample_min_height=1024, tile_sample_min_width=1024,
                       tile_sample_stride_height=768, tile_sample_stride_width=768)

# 条件图 ≤4 张:开 KV cache,拿 3.4× 加速
pipe(prompt=p, image=refs, use_kv_cache=True)

# 条件图 ≥5 张:必须关,否则 OOM。显存换时间,10 张可跑(38.4GB / 190s)
pipe(prompt=p, image=refs, use_kv_cache=False)
参数上,步数建议 24~30(严格线性,40 步相对 24 步的边际收益很小);true_cfg_scale 保持默认 1.0(开启即 2 倍耗时,而且不开质量也够);num_images_per_prompt 保持 1(batch 无规模效益);VAE 分块常开。
提示词上有三条经验:
要控视角,用词不用数。seen from directly behind 有效,rotated 180 degrees 无效。中文的「改成俯拍视角」同样有效。
指令没被响应时,先换 seed。带条件图时对 seed 高度敏感,这比反复改写提示词有效得多。
要透明,按官方句式写。开头一句「This is an RGBA image with transparency.」、结尾一句「The image has alpha channel and the background is transparent.」,不写就是普通不透明图。
没测的部分
- 9B 提示词改写模型的拒绝率。
- 用独立 mask 做局部编辑——官方宣称支持圈选、涂抹和独立 mask 三种方式,我测了前两种。
全部数字来自实测,失败样本已计入。逐张耗时、峰值显存、alpha 直方图和逐帧稳定性曲线都有原始记录。测试环境:单卡 RTX 4090 48GB,bf16 全量常驻,torch 2.14.0+cu130,diffusers 0.41.0.dev0。
内容核验说明
这份实测把 Qwen-Image-2.1 的显存占用、耗时、失败样本摊开讲,比榜单分数更能支撑部署决策:中文排版、原生 alpha 透明、多图身份保持是强项,「替换」容易退化成「添加」,带条件图时对 seed 高度敏感。做图像生成部署和提示词工程的人值得存。数据和结论来自作者单卡实测,诀.com 未独立验证,换环境结果可能不同。
文中的耗时、显存、alpha 直方图与图像样本均来自作者公开披露的单卡 RTX 4090 48GB 实测,诀.com 未独立验证,换硬件、版本或参数后结果不一定复现。作者也标明 9B 提示词改写模型的拒绝率、独立 mask 局部编辑未测,失效 seed 的解释只有单例证据。评论区整合
根据评论整合来看,回复里一半在调侃「有卡就是爽」、羡慕单卡 48GB 的硬件条件,也有人问候作者通宵、说机器受累。有回复认可这类评测的价值在于摊开显存、速度和失败率,而不是榜单分数。一条回复提到自己数据集测下来该模型没做安全墙和护栏就开源,认为离谱;另有回复说最近刷到不少帖子在夸这个生图模型。整体共识偏向认同评测方向,实质补充集中在硬件门槛与安全护栏两点。
基于原帖公开评论整理,只反映讨论中的观点与反馈,不代表诀.com 立场。原始来源
原作者:实践哥 Li(@MinLiBuilds)
本文对公开来源内容进行了结构化整理,原观点与内容归原作者所有。
查看原文