零 AI 产品经验,如何拿到 AI 产品 offer?附跟练&面试真题
作者 Leo 结合自己在字节跳动做 AI 产品实习、以及在 AI 初创公司继续做 AI 产品的经历,讲述零 AI 产品经验的人如何转行进 AI 产品岗。内容分四部分:先从 BOSS 直聘上的 5 条真实 JD 出发,翻译岗位要求并拆出产品基本功、AI 特有能力和加分项三层;再用一个旅行规划 Agent 串讲大模型、Token、上下文窗口、预训练/SFT/RL、Prompt 与 Context Engineering、Tool Use、Agent 与 Workflow、ReAct 与 Plan-and-Execute、RAG、Memory、MCP、Skill、Harness 等概念;接着讲项目选题与一个 Agent 项目的完整跟练步骤;最后讲 Agent 评测的做法,包括四类指标和按运行链路做归因的方法。;这是《零 AI 产品经验,如何拿到 AI 产品 offer?》一文的后半部分,从评测方法讲到求职全流程。内容包括:任务完成率的考点加权算法、用 pass^k 衡量稳定性、效率与成本指标的记录方式、LLM-as-Judge 机评的六条可信原则与持续校准办法、面向旅行规划 Agent 的最
大家好,我是 Leo,目前在做 AI 产品。
先交代一下背景:我本科在中山大学读力学,研究生转到中山大学读计算机。听起来像是“半个科班”,但说实话,我的编程基础很差。
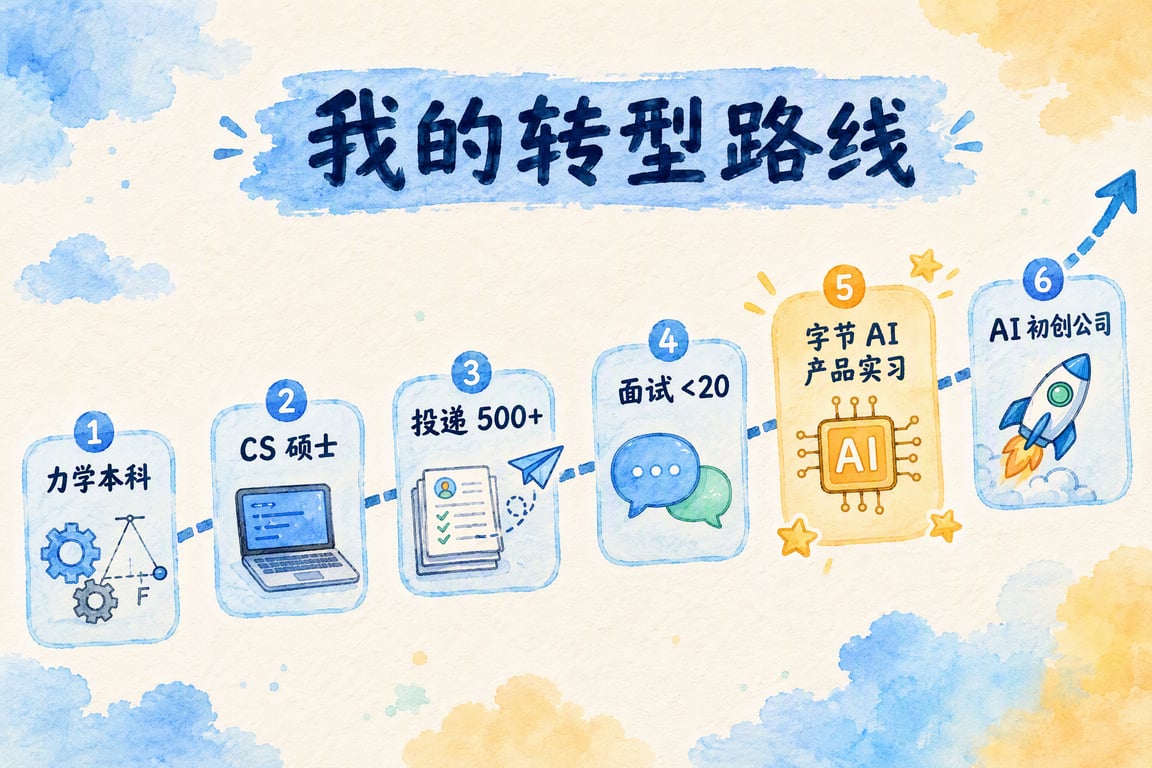
去年年底我开始找实习,当时手里的情况是:零实习经历,只有一个做得很简单的 AI 项目。我在 BOSS 直聘上投了 500 多家,最后拿到的面试不超过 20 家。今年 1 月,我拿到了字节跳动的 AI 产品实习。实习了 6 个月后,现在在一家 AI 初创公司继续做 AI 产品。
我写这篇文章,是想帮到所有想转 AI 产品的人:可能你是非计算机专业的在校生,也可能你已经在做传统产品、运营、设计,甚至在一个完全不相关的行业。这段时间和很多人聊下来,我发现大家卡住的往往是同一个念头:我不是科班出身,代码也写不好,AI 产品经理是不是轮不到我?
我的答案是:AI 产品不看出身,你真的有机会。而且在 AI 的帮助下,一个不会写代码的人,也完全可以做出自己的产品。“人人都是产品经理”这句话,放在 AI 时代比以前任何时候都更成立。
这篇文章会把我这一路的方法完整拆开,主要讲这几件事:
- AI 产品岗到底在招什么
- 必须懂的 Agent 基础概念,以及 SFT、RL 这些模型训练概念
- 怎么做一个能打动面试官的项目
- 我在字节做 Agent 评测时学到的方法
- 简历、投递和面试的整套打法
- 高频面试题和回答示范
全文用一个旅行规划 Agent 作为贯穿始终的例子,你可以照着做一遍。因为我自己是从找实习走过来的,求职部分会以实习为例,不过从项目、评测到面试的方法,换到社招转岗一样适用。
一、先看懂:AI 产品岗到底在招什么?
我开始准备的第一件事,就是打开 BOSS 直聘,筛出 10 条 AI 产品岗位的 JD,逐条拆解:每个岗位要求什么技能、加分项是什么,再拿自己的经历去一条条对照。
建议你也这么做。JD 是企业写给你的考纲,读懂它,你就知道该往哪里使劲。
下面是我最近在 BOSS 上挑的 5 条有代表性的岗位:两条大厂社招、一条高薪的资深岗、一条大厂日常实习、一条小公司实习。
1. 五条 JD 原文,翻译成人话
① 剪映 CapCut · AI Agent 产品经理(深圳,1-3 年,20-40K·15 薪)
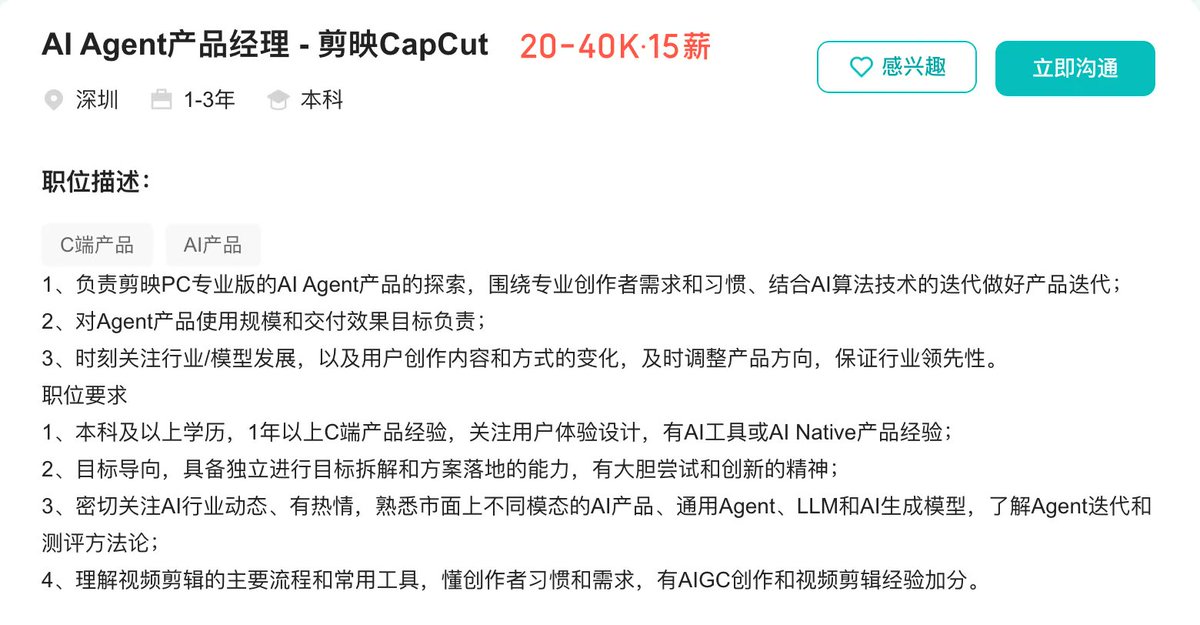
“对 Agent 产品使用规模和交付效果目标负责。”“熟悉市面上不同模态的 AI 产品、通用 Agent、LLM 和 AI 生成模型,了解 Agent 迭代和测评方法论。”“理解视频剪辑的主要流程和常用工具,懂创作者习惯和需求,有 AIGC 创作和视频剪辑经验加分。”
翻译一下:“对交付效果负责”,意思是你得能回答“这个 Agent 到底做得好不好”,这就是评测,JD 里也直接写了“测评方法论”。另外注意最后一条:AI 产品经理首先得懂某个具体场景,Agent 只是手段。做剪辑 Agent 的人,自己得懂剪辑。
② 抖音 · AI 产品经理(虚拟社交方向)(深圳,1-3 年,25-50K·15 薪)
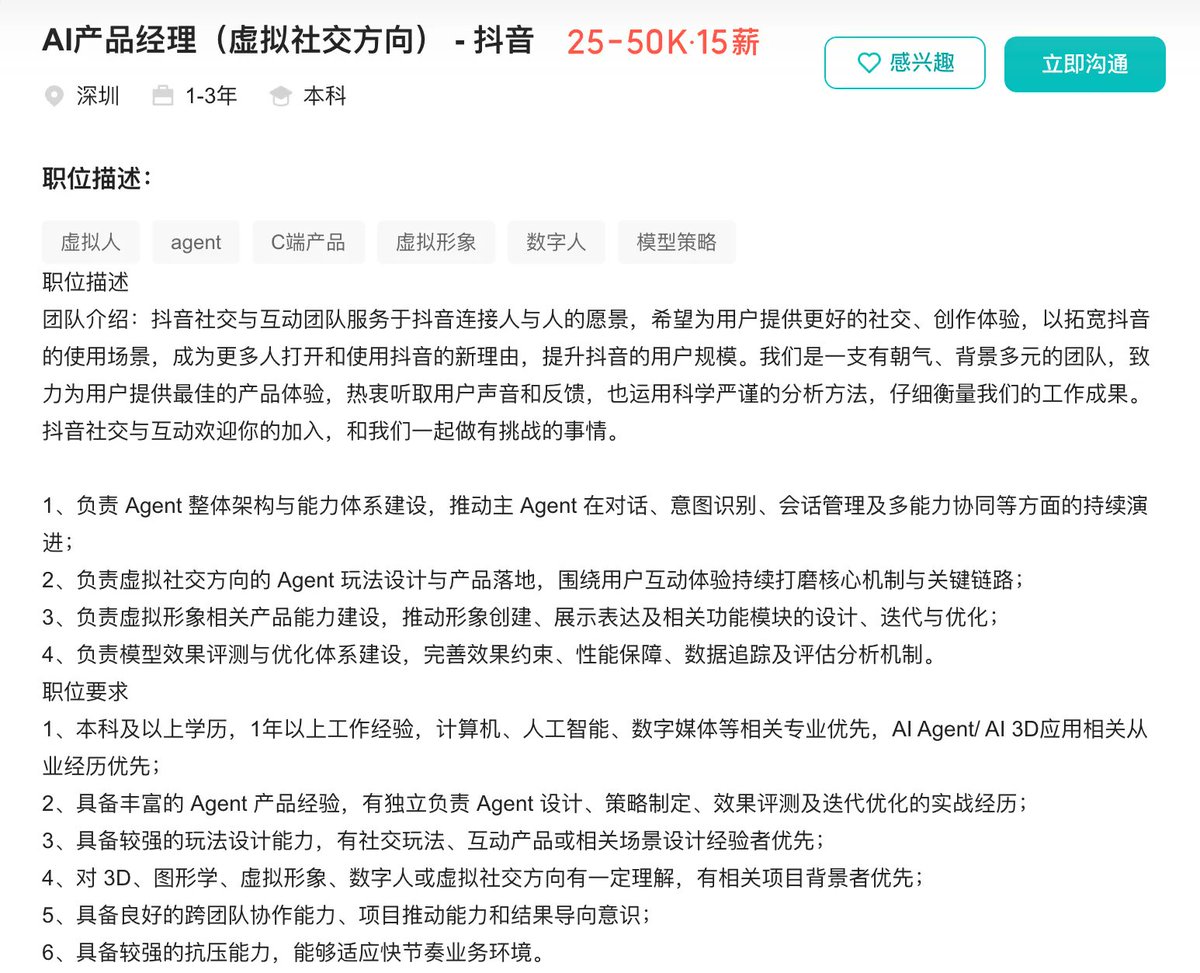
“推动主 Agent 在对话、意图识别、会话管理及多能力协同等方面的持续演进。”“负责模型效果评测与优化体系建设。”“有独立负责 Agent 设计、策略制定、效果评测及迭代优化的实战经历。”
翻译一下:意图识别、会话管理、多能力协同,对应的就是第二章会讲的规划、上下文、工具和 Skill。最后一句几乎就是一个 Agent 项目的完整闭环:设计 → 策略 → 评测 → 迭代。这也正是本文跟练要带你走一遍的流程。
③ 某公司 · AI 产品经理(深圳,3-5 年,70-100K·15 薪)
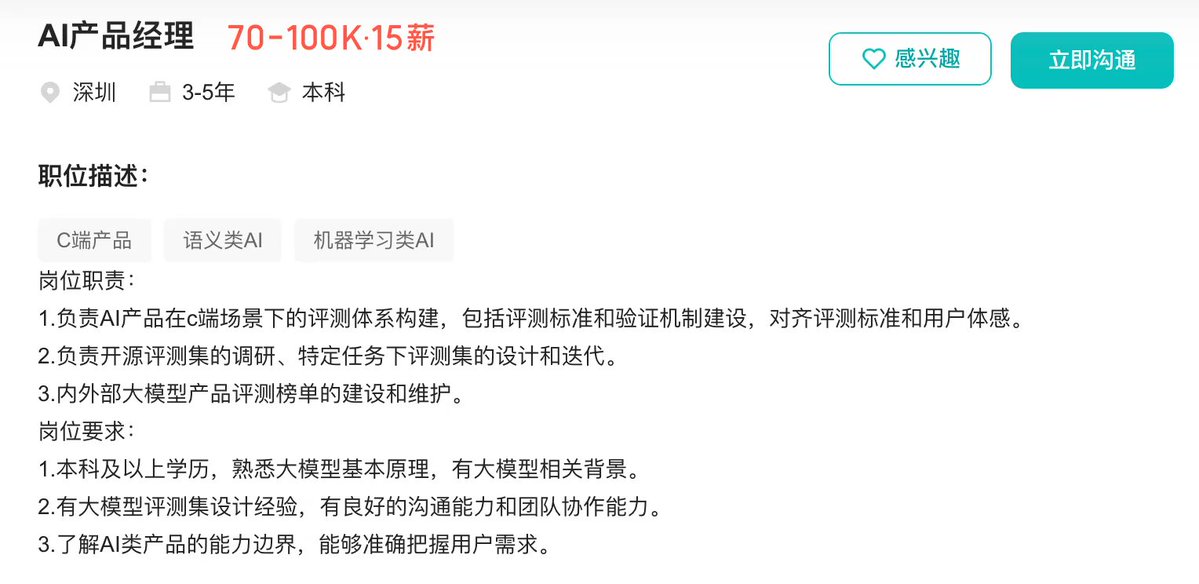
“负责 AI 产品在 C 端场景下的评测体系构建,包括评测标准和验证机制建设,对齐评测标准和用户体感。”“负责开源评测集的调研、特定任务下评测集的设计和迭代。”“内外部大模型产品评测榜单的建设和维护。”
翻译一下:这是我挑的几条里薪资最高的一条,整条 JD 没有一句在讲功能设计,全是评测。评测不是打杂,它可以是一个独立成立、而且很值钱的方向。
“对齐评测标准和用户体感”这句值得细品:如果评测分数很高,用户却觉得不好用,那这套评测就是失效的。评测标准最终要对用户的真实感受负责。
④ 字节跳动 Data-语音团队 · 语音大模型 AI 平台产品实习生(杭州,4 天/周,500-510 元/天)
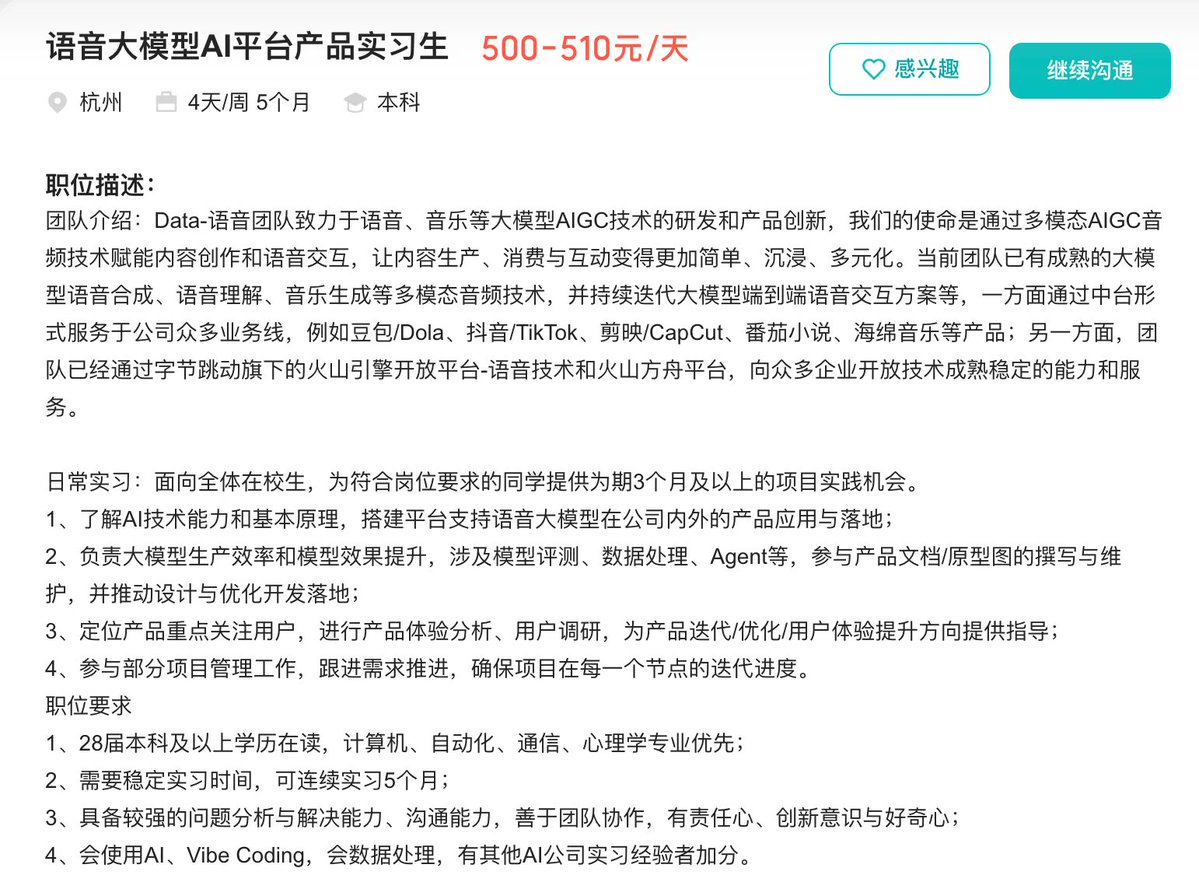
“了解 AI 技术能力和基本原理……负责大模型生产效率和模型效果提升,涉及模型评测、数据处理、Agent 等。”“计算机、自动化、通信、心理学专业优先。”“会使用 AI、Vibe Coding,会数据处理,有其他 AI 公司实习经验者加分。”
翻译一下:日常实习也明确写了模型评测和数据处理。请注意专业要求,心理学也在优先之列,这是“AI 产品不限专业”最直接的证据。“Vibe Coding”被写进 JD,说明企业不要求你会写代码,但希望你能借助 AI 把东西做出来。
⑤ 某公司 · AI 产品经理实习生(深圳,B 端,4 天/周,150-250 元/天)
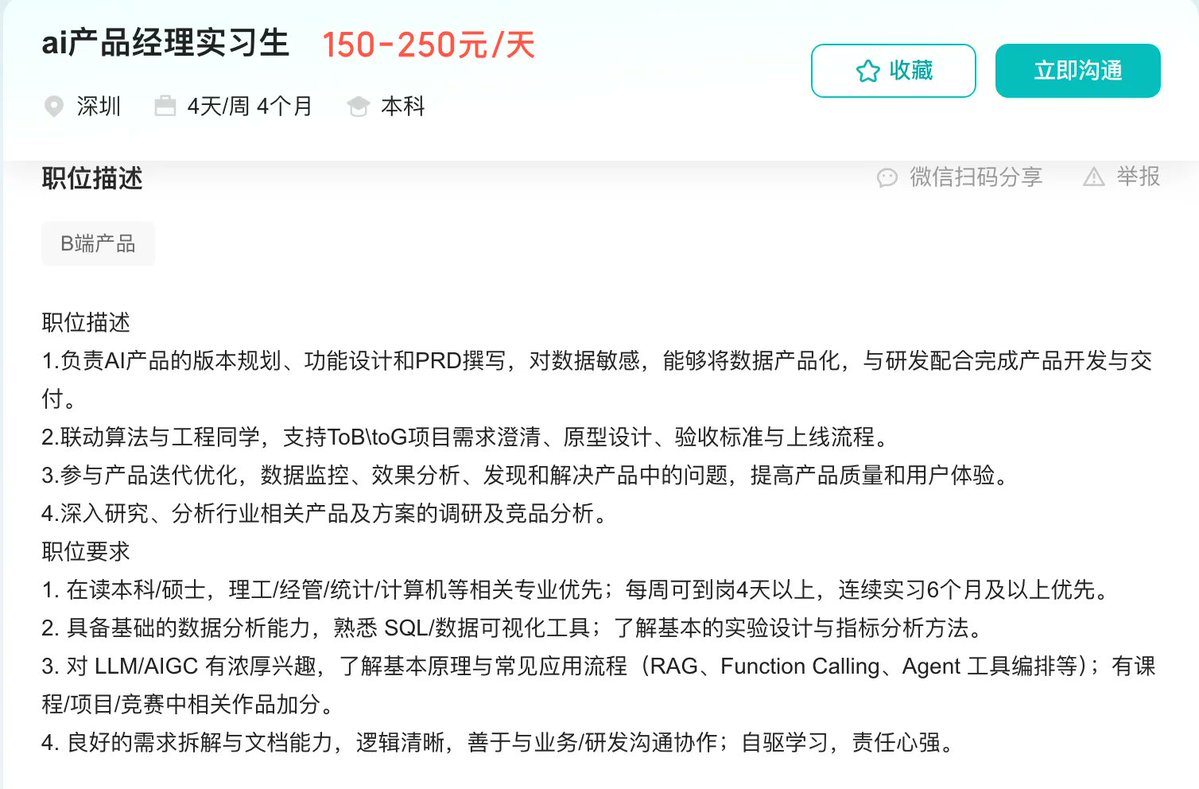
“负责 AI 产品的版本规划、功能设计和 PRD 撰写,对数据敏感,能够将数据产品化。”“具备基础的数据分析能力,熟悉 SQL/数据可视化工具;了解基本的实验设计与指标分析方法。”“了解基本原理与常见应用流程(RAG、Function Calling、Agent 工具编排等);有课程/项目/竞赛中相关作品加分。”
翻译一下:这是很典型的小公司实习岗,产品基本功(PRD、数据分析)占大头。AI 部分的要求是“了解”,列出来的 RAG、Function Calling、Agent 工具编排,第二章都会讲到。“有相关作品加分”说明项目就是你的敲门砖。专业写的是理工、经管、统计、计算机,范围也很宽。
2. 把五条 JD 放在一起看
按能力逐项对照,五条 JD 的要求是这样分布的:
- 懂 LLM / Agent 原理:①②③④⑤ 全部要求
- 评测:①②③④ 直接写了;⑤ 没直接写,但要求验收标准和效果分析
- 懂场景和用户:①②③④⑤ 全部要求
- 数据处理 / 分析:②③④⑤ 要求,其中 ③ 主要是评测集
- 能动手做出东西:④(Vibe Coding)、⑤(有作品加分)
放在一起看,能得出三个结论:
第一,评测是绕不开的能力。5 条里有 4 条直接写了评测,薪资最高的那条全是评测。这也是为什么这篇文章会把评测当作重点来讲。
第二,专业真的不是门槛。心理学、数字媒体、经管、统计都出现在了专业要求里。企业更在意的是你懂不懂 AI、懂不懂用户。
第三,对技术的要求是“了解原理”,不是“会写代码”。你要知道 Agent 怎么运转、模型大概是怎么训练出来的,但没人要求你去写训练代码。
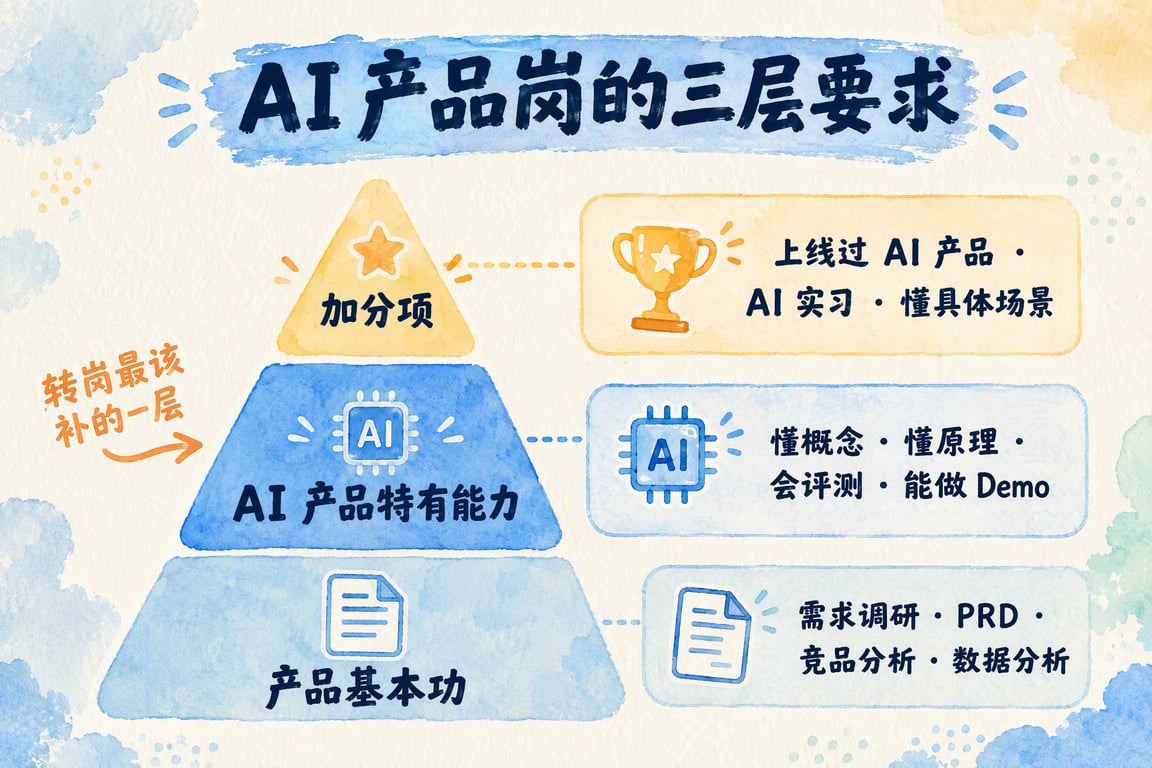
3. 从 JD 里拆出的三层要求
第一层:产品基本功。需求调研、需求拆解、写 PRD、竞品分析、画原型、基础的数据分析、跟进项目。这些和传统产品岗一样,是底线。
第二层:AI 产品特有的能力。这一层是 AI 产品岗和普通产品岗真正拉开差距的地方,主要有四块:
- 懂概念:理解 Agent、RAG、Workflow 这些概念在产品里意味着什么。
- 懂原理:大概知道模型是怎么训练出来的,SFT、RL 的训练数据长什么样,从而知道 AI 的能力边界在哪。
- 会评测:能定评测标准,能建评测集,能分析 Bad Case,判断 AI 哪里做得不好、为什么不好。
- 能做 Demo:能借助 AI 工具(也就是 JD 里写的 Vibe Coding),把想法变成一个可以演示的东西。
第三层:加分项。比如:
- 自己做过并且上线过 AI 产品
- 有 AI 相关的实习
- 懂某个具体场景,比如视频剪辑、AIGC 创作、社交玩法
- 持续关注行业动态,用过大量 AI 产品,对它们有自己的判断
对照完这三层,你会发现:非科班同学真正需要补的,主要是第二层。而第二层,恰恰是靠方法和练习就能补上的。
二、Agent 基础概念:用一个旅行规划 Agent 讲明白
现在绝大多数 AI 产品都在往 Agent 方向发展,所以想入门 AI 产品,Agent 的基础概念必须过关。下面这些概念,面试里几乎都会碰到。
为了不让概念悬在空中,我们先设定一个产品:
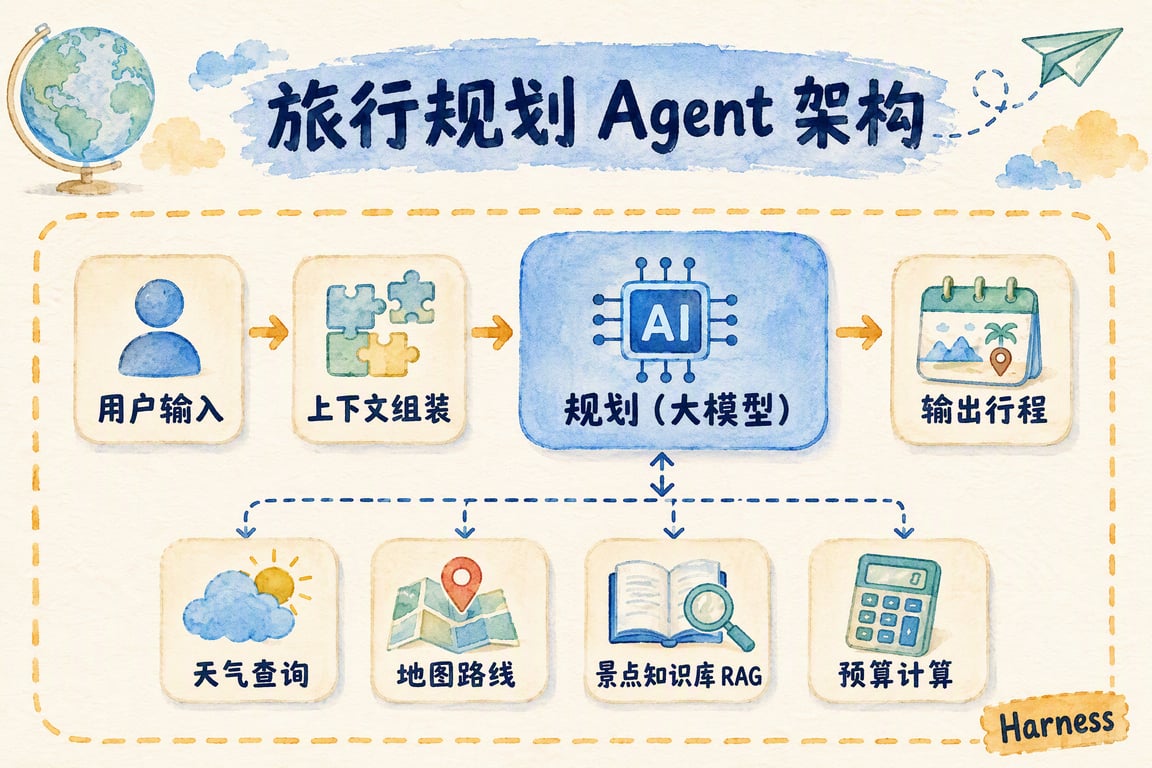
旅行规划 Agent:用户说“五一想和室友去杭州玩三天,人均预算 2000,不想太累”,Agent 自动查天气、查景点开放时间、规划路线、估算花费,最后给出一份可以直接用的行程。用户还可以接着说“第二天下雨怎么办”“预算再砍 500”,Agent 会跟着调整。
后面所有概念,都用这个产品来解释。
大模型、Token、上下文窗口
- 大模型做的事情,本质上是根据前面的文字预测下一个字。
- Token 是它计算文字量的单位,也是计费的单位。
- 上下文窗口是它一次能“看到”的最大内容量。
关于这几个概念,产品经理至少要知道两件事:
- 成本和速度都跟 Token 数量直接相关。旅行规划 Agent 每多查一次攻略、多塞一段历史对话,都在增加成本和等待时间。
- 上下文太长时,模型可能会忘掉或忽略中间的内容。用户第一轮说的“不想太累”,到第五轮可能就被它忘了。
模型是怎么“学会”的:预训练、SFT 和 RL
这一块很多同学会直接跳过,觉得是算法同学的事。我的看法是:产品经理不需要知道训练代码怎么写,但要大概知道训练数据长什么样。因为“什么样的回答算好”、数据从哪里来,很多时候是产品经理来定的。
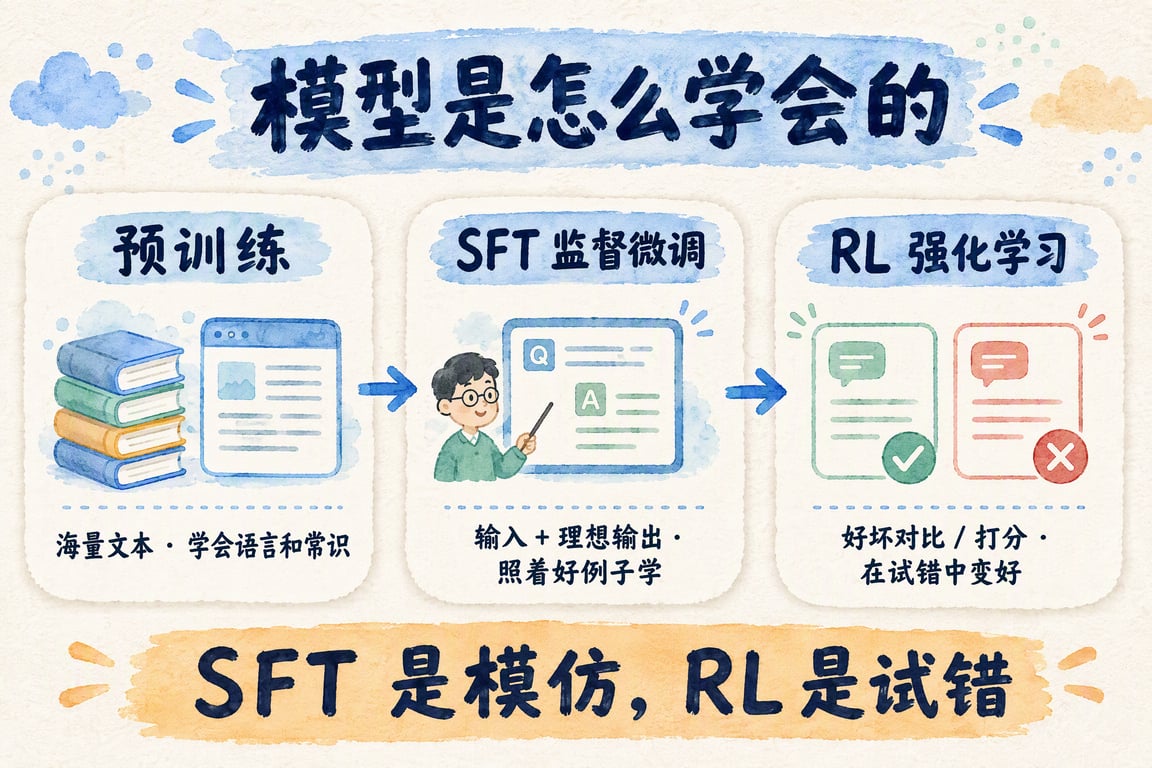
大模型的训练大致分三步。
① 预训练:读遍互联网,学会“接话”。
数据是海量的、没有标注的文本:网页、书籍、代码。模型在这一步学会语言和常识。这一步只有少数大模型公司在做,产品经理了解即可。
② SFT(监督微调):给它看标准答案。
数据是一条条“输入 + 理想输出”的示范。用旅行规划 Agent 举例,一条 SFT 数据大概长这样:
{
  "messages": [
    {"role": "system", "content": "你是一个旅行规划助手……"},
    {"role": "user", "content": "五一和室友去杭州玩三天,人均 2000,不想太累"},
    {"role": "assistant", "content": "(一份标准的三天行程:每天 2~3 个景点,附交通方式和预算明细)"}
  ]
}
到了 Agent 场景,SFT 数据会更长:示范的是一整条轨迹,包括什么时候调用天气工具、传什么参数、拿到结果之后怎么写行程。
一句话概括:SFT 是让模型“照着好的例子学”。示范数据的质量直接决定效果的上限,几千条高质量数据,往往比几万条随手写的更有用。示范该怎么写、什么样才算标准答案,就是产品经理要参与定义的。
③ RL(强化学习):不给标准答案,只告诉它好不好。
RL 的数据常见有两种形态。
第一种是偏好对比数据:同一个问题给出两个回答,标注哪个更好。
{
  "prompt": "第二天下雨怎么办?",
  "chosen": "把第二天的西湖骑行换成浙江省博物馆 + 中国茶叶博物馆,以室内为主,两地之间交通约 20 分钟",
  "rejected": "下雨也可以去西湖,雨中的西湖别有一番风味"
}
RLHF 会先用这类数据训练一个“打分模型”(奖励模型),再用它的打分去引导大模型;DPO 这类方法则直接拿偏好对来训练。
第二种是可以自动验证的奖励:对错能用规则判断的任务,比如数学题答案对不对、代码能不能跑通。放到旅行规划里,“总花费有没有超预算”“景点是不是在开放时间内”都能写成规则自动判分。对 Agent 来说,就是让它在环境里完整跑一遍任务,最后按任务完成得怎么样给奖励。
一句话概括:SFT 是模仿,RL 是试错。SFT 让模型学会格式和基本做法,RL 让它在没有唯一标准答案的地方学会做得更好。
这件事和产品经理的距离,比想象中近得多。RL 的核心是奖励:什么样的结果算好、好多少。这和第四章要讲的评测标准,本质上是同一件事。你给旅行规划 Agent 定的考点、写的 LLM-as-Judge,换个用途就是奖励信号;评测里积累下来的 Bad Case 和人工修正后的好答案,就是下一轮 SFT 数据和偏好数据的来源。所以在很多团队里,评测、数据标注规范和奖励设计是连在一起的,产品经理会深度参与。
还有一个面试常问的判断:效果不好时,先别急着想微调。一般的顺序是先改 Prompt 和上下文,再接 RAG 补知识,最后才考虑 SFT 或 RL。微调成本高、周期长,适合“输出格式和风格要求高度稳定”“同一类任务大量重复”的场景;而像景点票价这种更新很快的知识,用 RAG 解决更合适。
Prompt 和 Context Engineering
Prompt 是你给模型下的指令,比如“你是一个旅行规划师,请根据用户需求生成行程”。
Context Engineering(上下文工程)关心的范围更大:在模型做每一步决定之前,决定把哪些信息放进它的视野。这些信息包括:
- 系统指令
- 用户的历史要求
- 查到的天气和景点信息
- 工具返回的结果
现在业内越来越认同,Agent 好不好用,很大程度上取决于上下文给得对不对,而不只是 Prompt 写得好不好。
比如用户在第三轮把预算从 2000 改成 1500,如果上下文里同时留着两个预算、又没标明哪个是最新的,模型就可能按旧预算来排行程。
Tool Use(工具调用 / Function Calling)
模型本身只会输出文字。工具调用让它能“伸手做事”:
- 模型判断出需要查一下杭州五一的天气,并给出参数(城市:杭州,日期:5 月 1 日)。
- 系统去调用天气接口。
- 系统把结果交回给模型。
旅行规划 Agent 用到的工具可能有:天气查询、地图路线计算、景点信息搜索、酒店价格查询。工具调用是模型从“会聊天”变成“能办事”的关键一步。
Agent 和 Workflow 的区别
这是面试里很常见的问题。
Workflow(工作流)是人提前画好流程图,模型在固定节点上完成任务。比如固定流程:查天气 → 查景点 → 排行程 → 算预算。
- 优点:稳定、可控。
- 缺点:遇到流程图之外的情况就不会处理。
Agent(智能体)是模型自己决定下一步做什么、调用什么工具、什么时候结束。比如用户突然说“第二天下雨”,Agent 会自己判断要把户外景点换成室内的,再重新查路线。
- 优点:灵活。
- 缺点:不太可控,成本也更高。
产品经理要能判断你的场景该用哪种。一个比较好的回答思路是:
- 步骤固定、出错代价高的环节,用 Workflow 兜住。
- 路径不确定、需要根据情况临场调整的环节,才交给 Agent。
旅行规划其实很适合混合使用:预算计算这种确定性的事情走固定逻辑,行程调整这种开放性的事情交给 Agent。
ReAct 和 Plan-and-Execute
这是 Agent 最常见的两种工作方式。
ReAct:想一步、做一步、看结果、再想下一步,边做边调整。
比如:先查天气 → 发现第二天有雨 → 再去查室内景点 → 发现某博物馆周一闭馆 → 再换一个。
- 优点:灵活。
- 缺点:步骤多了容易跑偏,也更费 Token。
Plan-and-Execute:先把整个计划列出来,再按顺序执行。
比如:先定好“三天的行程框架:第一天西湖、第二天灵隐、第三天市区”,再逐天去查细节、填内容。
- 优点:结构清楚,适合步骤明确的长任务。
- 缺点:遇到计划之外的情况时,调整得比较慢。
做项目时,你一定要想清楚自己的 Agent 用的是哪种范式、为什么用它。面试官很可能会问。
RAG(检索增强生成)
先从知识库里找到相关资料,再让模型根据资料回答。
旅行规划 Agent 可以接一个“景点知识库”:开放时间、门票价格、游玩时长、避坑提示。这样模型就不用凭记忆瞎编“这个景点几点开门”。
RAG 主要解决两个问题:模型不知道最新或私有的信息,以及模型会一本正经地编造内容(也就是“幻觉”)。
产品经理要关心三件事:
- 知识库的质量够不够好
- 能不能检索到对的那条资料
- 回答里有没有标出处
Memory(记忆)
短期记忆是当前对话里的内容,比如这次说的“不想太累”。
长期记忆是跨越多次对话还能记住的信息,比如“这个用户不吃辣”“他每次都选经济型酒店”。
产品上要考虑三件事:该记住什么、用户能不能查看和删除记忆、记错了怎么办。
MCP(Model Context Protocol)
可以把它理解成 AI 世界的 USB 接口。
以前每个 AI 应用想接一个地图服务,都要单独开发一遍对接。有了 MCP,工具只要按统一标准接入一次,各种 AI 应用都能直接用。
产品经理要明白它的意义:降低对接成本,让 Agent 能用的工具越来越多。
Skill(技能)
把完成某类任务需要的说明、流程和参考资料打包成一个模块,Agent 需要的时候才加载。
比如给旅行规划 Agent 做一个“亲子游规划”Skill,里面写清楚亲子游要注意什么:午休时间、景点的儿童友好度、推车能不能进。只有用户提到带小孩时才加载。
它解决的问题是:所有能力都塞进 Prompt 里,上下文会爆掉。
一句话区分:MCP 解决的是“能连接什么工具”,Skill 解决的是“知道怎么把一件事做好”。
Harness(Agent 的运行框架)
如果模型是大脑,Harness 就是除模型以外的整套装置,包括:
- 循环怎么跑
- 工具怎么调
- 上下文怎么管理
- 权限怎么控制
- 出错了怎么重试
Claude Code、Cursor 这类产品,本质上都是包在模型外面的 Harness。
这个概念对产品经理很重要:用的是同一个模型,Harness 设计得好坏,决定了产品体验的差距。而 Harness 的很多设计决策,正是产品经理需要参与的。
三、项目:面试官真正在意的是“为什么”
1. 我的第一个项目其实很“玩具”
说出来可能有点不好意思:我找实习时唯一的项目,是一款记录食物热量的 AI 应用。说白了,就是一个套壳应用:用户拍照,调用大模型识别食物,估算热量。
技术上它一点都不复杂,但它帮我拿到了面试,最后也帮我拿到了字节的 offer。原因有两个。
第一,面试官本身大多是产品经理,很多产品经理并不懂代码。所以面试时基本不会深挖你代码写得怎么样,他们更关心的是:
- 你为什么想做这个产品?
- 这个产品的目标用户是谁?
- 它解决了目标用户的什么问题?
这三个问题你能答得清清楚楚、有理有据,项目简单一点并不要紧。
第二,我把这个应用上架到了 iOS App Store。在当时,这是一个明显的加分项。很多面试官对上架流程很好奇,面试中会专门问我。“做出一个真的上线、别人能下载的东西”,本身就证明了你能把事情从头做到尾,比停在 Demo 阶段的项目有说服力得多。
不过要说清楚:上架 App Store 不是必须项。它有实打实的成本:苹果开发者账号每年要交几百块,审核流程也要花时间。如果你做的是网页,在国内上线又要折腾备案这类手续。对学生来说,这些投入不一定划算。
更重要的不是“上架”这个动作,而是有真实用户在用。做一个网页端产品,哪怕只是一个链接,拉一批真实用户用起来,收集反馈、看使用数据、根据反馈迭代,这同样是很大的加分项。面试时你能讲出“我有多少用户、他们怎么用、我根据反馈改了什么”,比单纯说“我上架了”更有说服力。
2. 但 2026 年,我建议你做一个 Agent
我当时做的套壳项目,在那个时间点是够用的。
但从我这一年在字节和初创公司的观察来看,AI 产品岗的门槛在变高。上面那 5 条 JD 里,Agent、评测、数据处理、Vibe Coding 这些词反复出现。
所以如果你现在开始准备,我建议在我的基础上升级一步:做一个垂直场景的 Agent,并且给它做一套评测。
你不需要会写代码。用 Coze、Dify 这类搭建平台,或者借助 Cursor、Codex、Claude Code 这样的 AI 编程工具,都可以把它做出来。
但你必须做到两点:
- 搞清楚 Agent 的范式是怎么回事
- 在动手之前,想清楚为什么要做这个产品
下面用旅行规划 Agent 完整走一遍。
3. 跟练:从零做一个旅行规划 Agent
第一步:想清楚需求背景,先回答“为什么”
动手搭之前,先用几段话回答这几个问题。这些也是面试官一定会问的。
- 服务谁?不要写“所有想旅游的人”,要具体到人群和场景。比如:没什么旅行经验、预算有限、经常利用小长假和室友出去玩的在校大学生。
- 他们现在怎么解决这个问题?刷小红书、翻马蜂窝攻略,自己在备忘录里拼行程,再一个个去地图上查距离。
- 痛点在哪?
- 攻略分散在各个平台,信息可能已经过期。
- 景点之间的距离和交通时间要自己算。
- 预算靠心算。
- 中途天气变了或者有人不想去某个地方,整个行程得重排。
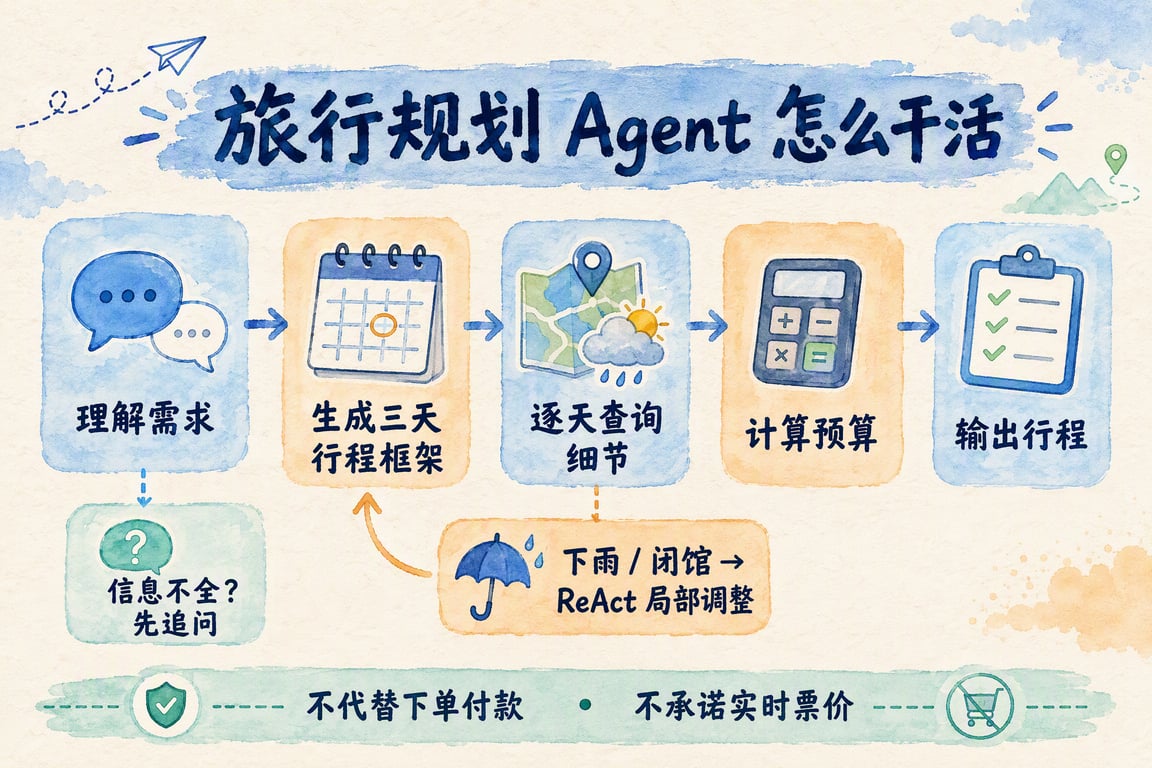
- 为什么要做成 Agent,而不是一个攻略搜索工具?因为这个任务天然需要多步骤、多工具协作,还要随着用户的反馈不断调整:查信息 → 排行程 → 算预算 → 根据变化重新规划。这正是 Agent 擅长的事情。
判断标准是:每一个结论,你都能说出“我是从哪里看出来的”。最好去小红书、即刻翻一翻用户真实的吐槽,或者访谈几个同学,把他们的原话记下来。
第二步:设计 Agent 的能力和范式
- 工具:天气查询、地图路线计算、景点信息检索(可以自己整理一个小的景点知识库来做 RAG)、预算计算。
- 范式:先用 Plan-and-Execute 生成行程框架,保证结构清楚;遇到天气变化、景点闭馆这类意外情况时,用 ReAct 的方式局部调整。你要能说清楚为什么这样选。
- 记忆:短期记住本次对话的预算、天数、偏好;可以考虑长期记住用户的出行习惯。
- 边界:哪些事情 Agent 不做。比如不代替用户下单付款、不承诺实时票价一定准确。
第三步:搭建出来
选一个你最顺手的平台或工具搭出第一版。
不用追求完美,能跑通“用户输入需求 → 生成一份可用的行程”这条主线就可以。过程中遇到的问题,大多可以直接问 AI。
第四步:做评测,并基于评测迭代
这是整个项目里最能拉开差距的一步。我单独用下一章来讲。
第五步:如果可以,让真实用户用起来
我的经验是,“真的上线了、有人在用”会显著提升项目的说服力。
不需要上架应用商店。做成一个网页端产品,把链接发到同学群、小红书或即刻,哪怕只拉来 20 个同学试用,也比一个只在自己电脑上跑过的 Demo 强。
如果你愿意多走一步,就把这些用户当成真正的客户来运营:
- 建一个反馈群,定期问大家用得怎么样
- 记录有多少人用过、多少人用了第二次
- 把用户吐槽最多的问题加进评测集,作为下一版要修的 Bad Case
这样,你的项目就从“我做了一个 Agent”变成了“我做了一个有用户、有数据、在持续迭代的产品”。
四、评测:最能拉开差距的一项能力
在字节实习期间,我有一部分工作是做抖音图像视频创作 Agent 的评测。
进去之前,我以为评测就是看看结果好不好、打个分。进去之后才明白,评测关系到 Agent 迭代的方向。一个 Agent 好不好、哪里不好、该先改哪里,都要靠评测来回答。没有评测,团队的每一次迭代基本都是凭感觉。
这也是我最推荐在校生去练的能力。会搭 Agent 的人越来越多,但能讲清楚“我的 Agent 到底好不好,凭什么这么说”的人很少。
1. Agent 评测为什么和传统评测不一样
评测一个普通的大模型问答很简单:给一个问题,拿到一个答案,和标准答案比一比,打个分。
Agent 不一样。它会多步规划、调用工具、读写数据。最后的结果看起来对了,过程却可能是错的。业内把这种情况叫“静默失败”。
举个例子。用户说“预算 1500,三天”,旅行规划 Agent 给出了一份总价 1480 的行程,看起来完美。但检查过程会发现,它其实根本没有调用价格查询工具,酒店价格是自己编的,只是碰巧编得不离谱。只看结果,你永远发现不了这个问题,换一个城市它就会出错。
所以 OpenAI、Anthropic、Google 公开的 Agent 评测方法,都在往同一个方向走:
- 不只看结果,还要记录完整的运行过程(Trace)。
- 把有代表性的任务沉淀成可以反复运行的测试集。
- 用“程序化校验 + LLM-as-Judge + 人工校准”混合的方式打分。
- 最终能从失败的结果反推出是哪个环节出了问题。
2. 评什么:四类指标,不要揉成一个总分
① 结果质量(主门槛):任务完成没有、内容准不准、有没有编造。放到旅行规划 Agent 里,就是看行程是否满足天数和预算,景点是否真实存在、开放时间是否正确。
② 过程质量(诊断维度):意图理解、规划合理性、工具调用是否正确。比如有没有理解“不想太累”,是否先查开放时间再排行程,调用地图时城市参数对不对。
③ 效率与成本(优化维度):用户等了多久、花了多少 Token。比如生成一份三天行程要等多久、消耗多少 Token。
④ 安全与稳定(硬门槛):有没有越权或危险输出,同样的任务每次能否都成功。比如是否擅自替用户下单;同一个需求跑 5 次,是否每次都能给出可用的行程。
最常见的错误,是把这些维度揉成一个综合分。
一个分数很高、但又贵又慢、结果还不稳定的 Agent,在报告里不应该和一个又便宜又快又稳的 Agent 看起来一样好。正确的顺序是:先看安全,再看结果,最后优化过程和效率。
3. 我学到最重要的一课:归因要能指向具体环节
这是我在实际工作里体会最深的一点。
我们第一版评测标准里,有一些归因标签是从“结果出了什么问题”出发设计的,比如“没有生成内容”。这个标签看起来很具体,但研发拿到之后根本不知道该改哪里。可能是:
- 意图理解错了
- 选错了技能
- 技能本身有缺陷
- 底层的生成模型报错了
根因定位不了,就没法有针对性地优化。
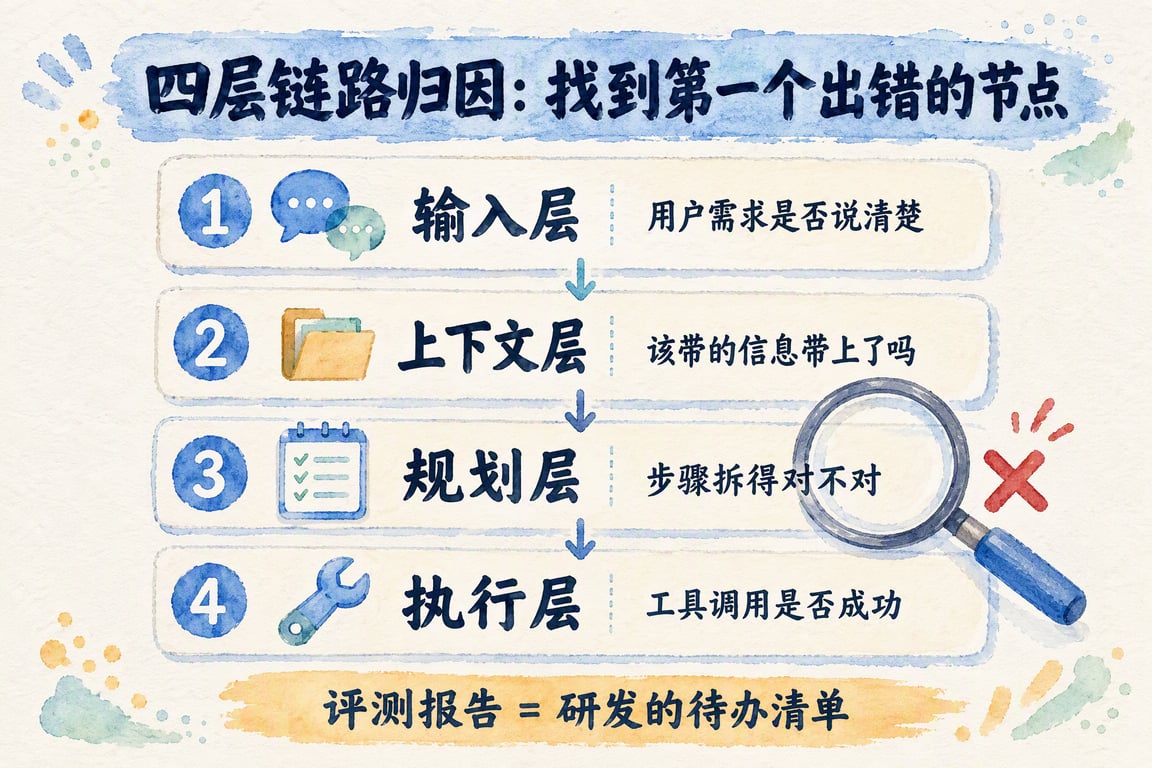
后来的新版标准做的一件重要的事,就是按 Agent 实际的运行链路把过程拆成几层,每一层都有自己的指标和归因标签。套到旅行规划 Agent 上,是这样的:
- 输入层:用户的输入有没有完整、正确地进入系统?
用户上传了一张机票截图,说“按这个航班时间排行程”。结果截图没有被正确解析,后面排的行程和航班时间对不上。
- 上下文层:模型行动之前,该给它的信息有没有给对?
用户第一轮说预算 2000,第三轮改成 1500,系统却还把 2000 当作有效要求;或者历史对话丢了,用户说“把刚才第二天的行程换一下”,模型根本不知道“刚才”是什么。
- 规划层:有没有理解用户真正想要什么?方案合不合理?
- 意图理解错误:用户只说了一句“帮我规划一下周末出去玩”,没说去哪、从哪出发。这时候应该先追问,而不是直接编一份行程。
- 规划不合理:用户说“不想太累”,结果一天排了 6 个景点;或者没有先确认景点开放时间,就把闭馆日的博物馆排了进去。
- 执行层:有没有按计划调用工具?工具返回的结果能不能用?
- 调用出错:计划要查杭州的路线,调用地图工具时却传成了“苏州”。
- 结果不能用:景点知识库返回了空结果,Agent 没有提示用户,而是自己编了一个景点。
这样拆完,每一个失败案例都能找到“第一个出错的节点”,评测报告也就变成了研发的待办清单:该改 Prompt 的改 Prompt,该修工具的修工具,该补知识库的补知识库。
4. 任务完成率怎么算:拆考点,再加权
「任务有没有完成」听起来很简单,但用户经常在一次对话里提好几个要求,中途还会修改。一个比较好用的做法是:先把用户的需求拆成若干个考点,再按重要程度给每个考点不同的权重。
拿「五一和室友去杭州玩三天,人均预算 2000,不想太累,第二天如果下雨换成室内活动」这个需求举例:
否决型(底线,没做到直接判失败):行程中不能出现不存在或当天闭馆的景点;不能编造价格。
核心型(关键交付):
- 天数正确
- 目的地是杭州
- 人均花费不超过 2000
- 第二天有下雨的备选方案
一般型(细节要求):
- 每天景点数量适中,体现「不想太累」
- 景点之间的交通时间合理
每个考点只打 0 分或 1 分。只要有一个否决型考点得 0,这个任务直接判 0。否则按权重加权平均:
任务得分 = Σ(考点得分 × 考点权重)÷ Σ 考点权重
也就是把每个考点的得分乘上它的权重,全部加起来,再除以所有考点的权重之和。
如果一次对话里有多个独立的需求,就先分别算出每个需求的得分,再取平均。
这样算的好处是:分数低的时候,你能直接看到是哪个考点没做到,而不是只拿到一个说明不了问题的「7 分」。
5. 稳定性:一次成功不算数
我们在复查失败案例时遇到过一种情况:上次评测失败的任务,重新跑一遍又成功了。
这说明大模型本身有随机性,只跑一次的结果并不可信。
业内常用 pass^k 来衡量稳定性:同一个测试样本独立跑 k 次,k 次全部成功才算通过。
对真实用户来说,一个十次里只能成功七次的旅行规划 Agent,体验其实很差。用户不会管你「大部分时候是好的」,他只会记住那次给他排了闭馆景点的经历。
6. 效率和成本:别等上线了才发现
效率和成本很容易被忽略,但它们往往是决定一个 Agent 能不能上线的现实问题。
建议从第一版评测开始就记录两组数据:
- 用户等多久:首个字出来的时间、完整行程生成完的时间。
- 花多少钱:每轮对话的输入和输出 Token。
如果等到上线前才发现一次规划要消耗大量 Token、等一分多钟,很可能要回头重新设计整条链路。
7. 机评:LLM-as-Judge
人工评测最准,但又慢又贵,测试集一大就跑不动。所以越来越多的团队开始让大模型来当评委,也就是 LLM-as-Judge。
从我的观察来看,很多小公司还处在人工评测阶段,大厂已经在逐步推进机评的建设。如果你的项目里有 LLM-as-Judge,简历上会是一个明显的加分项。
但机评必须先做到「可信」。几条原则:
- 每个维度单独评。一个评委只负责一个维度。比如「预算是否达标」一个评委,「行程是否真实可行」一个评委,不要让一个模型包办所有打分。
- 让评委做选择题,不要写作文。打 0/1 分,或者在几个选项里选一个,比让它自由写一段评价稳定得多。
- 给评委一个「无法判断」的选项。信息不够时让它说「无法判断」,避免它被迫乱判。
- 先用人工标注做校准。同一批样本,人工打一遍,机器打一遍,计算两者的一致率。一致率达到你设定的标准之后,才能用机评代替人工。
- 注意位置偏差。对比 A、B 两个版本时,交换一下两个答案的先后顺序再评一次。研究发现,仅仅调换顺序就可能改变评委的判断。
- 不要只评一次。多次采样或多个评委取共识,比单次判断更可靠。
用上机评之后,也要持续人工抽检。校准不是一次性的。Agent 每迭代一版、评分规则每改一次,评委的判断都可能跟着跑偏。所以要定期从机评结果里随机抽一部分做人工复核,评委判了「无法判断」的样本也都交给人工来看。一旦发现一致率下降,就回头调整评分规则和评委 Prompt。
8. 跟练:给旅行规划 Agent 搭一套最小评测
建测试集。准备 30 到 50 条测试样本,覆盖三类情况:
- 典型情况:「周末去苏州两天,预算 1000」。
- 边界情况:多人不同预算、跨城市行程、用户中途多次修改要求。
- 对抗情况:信息不全(「帮我规划一下出去玩」)、需求互相冲突(「预算 500 玩遍三亚五星酒店」)。
最好的测试样本,往往来自你已经见过的失败案例。
定评分规则。按上面的四个维度、四层链路和考点法,写清楚每一项怎么判 0 分、怎么判 1 分。
人工打一遍。这一遍的结果作为基准。
写评委 Prompt,跑一遍机评。和人工结果比较一致率。不达标就继续调整评分规则和 Prompt。
迭代和回归。每改一版 Agent,就用同一套测试集重跑,记录指标变化,把每个失败案例归到具体的环节上。
做完这一套,你手里就有了一份真实的迭代记录:
- 第一版任务完成率是多少
- 主要失败集中在哪一层
- 你改了什么
- 第三版提升了多少个百分点
这些都可以写进简历。
五、简历:用 STAR 法则把项目写「硬」
简历的每一条经历,建议用 STAR 法则来写:
- S(Situation,情境):什么背景
- T(Task,任务):你要解决什么问题
- A(Action,行动):你具体做了什么
- R(Result,结果):带来了什么可以量化的结果
修改前:
独立开发旅行规划 Agent,使用 Dify 搭建,支持行程规划功能。
修改后:
旅行规划 Agent|独立负责
针对大学生小长假出行「攻略分散、行程难排、预算难控」的问题,访谈 [X] 名同学,定义目标用户与核心场景;
设计「Plan-and-Execute 生成框架 + ReAct 局部调整」的 Agent 方案,接入天气、地图路线、景点知识库等工具;
搭建评测体系:按输入、上下文、规划、执行四层拆解过程指标,构建覆盖典型、边界、对抗场景的 [50] 条评测集;搭建 LLM-as-Judge 自动评测,与人工标注一致率达 [X]%;
基于 Bad Case 归因迭代 [3] 个版本,任务完成率从 [X]% 提升至 [Y]%,pass^5 从 [X]% 提升至 [Y]%。
提醒:简历上的数字必须是你真实跑出来的。面试官很可能追问「一致率怎么算的」「失败主要集中在哪一层」「你改了什么才提升的」。能答上来,这一条才是真正的加分项。
六、投递和面试:把求职当成一个产品来运营
我在 BOSS 上投了 500 多家,最后面了不到 20 家。零实习、项目单薄的时候,回复率低是正常的。你需要的是一套能持续运转、不断复盘的系统,而不是靠运气。
1. 先投小公司,积累面试经验
不要一上来就冲大厂。
先投一批小公司和初创公司,把面试当作练习:熟悉常见问题,打磨自我介绍和项目讲述,找到自己的薄弱点。等表达稳定下来,再去投你真正想去的公司。
2. 用飞书表格管理投递
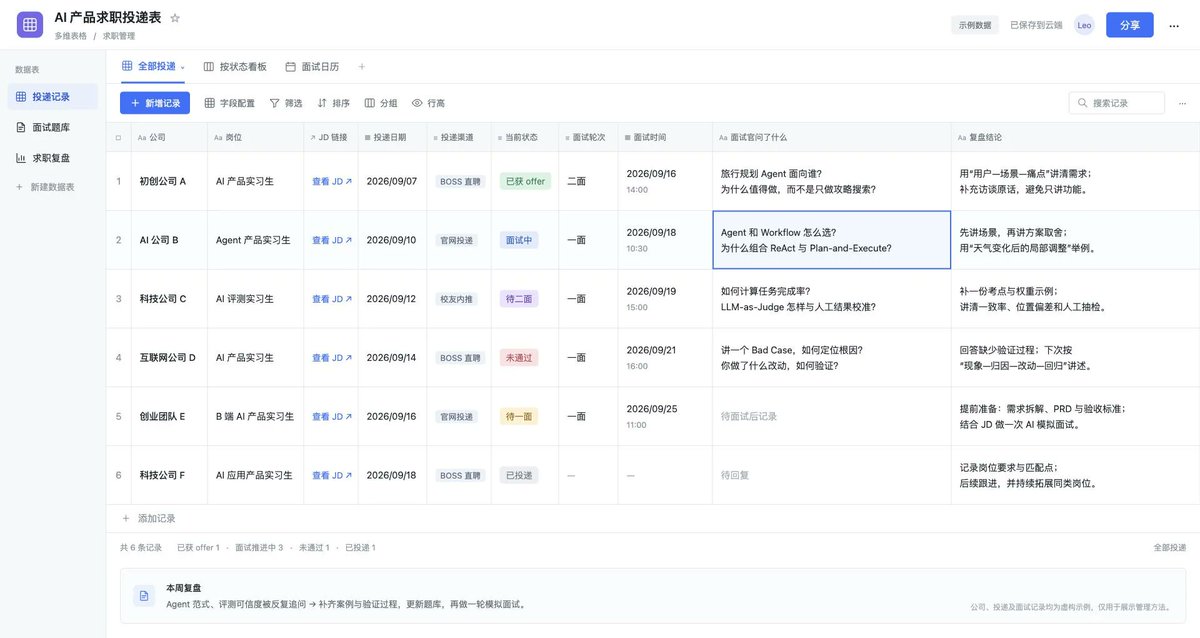
投递量一大,不记录就会乱。建议建一张飞书多维表格,至少记录这些字段:
- 公司
- 岗位
- JD 链接
- 投递日期和渠道
- 当前状态
- 面试轮次和时间
- 面试官问了什么
- 复盘结论
一段时间后回头看,你就能发现哪类岗位回复率高、哪类问题总答不好。
3. 每场面试都录下来复盘
在征得对方同意、遵守相关规则的前提下,可以用 AI 会议记录工具记下面试内容。面完马上复盘:
- 哪个问题答得不好
- 面试官在哪里追问了
- 下次怎么答
4. 整理属于自己的面试题库
把每场面试被问到的问题都收进题库,按类型分好:
- 自我介绍
- 项目深挖
- AI 概念
- 产品设计
- 行为面
每个问题写下你的最佳回答,持续更新。面到后面你会发现,大部分问题都是题库里已经有的。
5. 用 AI 做模拟面试
这个环节非常重要。把目标岗位的 JD 和你的简历发给 AI,让它扮演面试官。可以参考这样的指令:
你是 【公司】 的 AI 产品经理面试官。请根据下面的 JD 和我的简历,对我进行一场 30 分钟的面试。每次只问一个问题,根据我的回答继续追问细节。面试结束后,指出我回答中最薄弱的三个地方,并给出改进建议。
真实面试之前,先被 AI「拷打」几轮,紧张感会少很多。
6. 多利用校友关系
校友资源是我非常推荐大家用起来的。具体可以这样做:
- 在领英、脉脉上找在目标公司做 AI 产品的师兄师姐。
- 在学校的就业群、实验室群里问问有没有内推。
- 礼貌地请教岗位情况。
内推不仅能提高简历被看到的概率,师兄师姐对团队和面试的一手信息也非常宝贵。
七、高频面试题与回答示范
下面的示范回答都以旅行规划 Agent 为例。方括号里的内容可以换成你自己真实的数据和经历。
1. 介绍一下你的项目,你为什么想做它?
回答公式:你观察到的问题 → 目标用户 → 产品是什么 → 你为什么选它
我注意到身边同学每次小长假出去玩,都要在小红书、马蜂窝之间来回翻攻略,再自己算距离、排行程、控预算,一次规划要花好几个小时,中途天气一变又得重来。所以我做了一个旅行规划 Agent,面向预算有限、旅行经验不多的大学生。用户只要说出目的地、天数、预算和偏好,它就会查天气、查景点、规划路线、估算花费,并且能根据用户的反馈调整。我选这个场景,是因为它天然需要多步骤、多工具协作,很适合用来验证 Agent 的能力。
2. 目标用户是谁?解决了他们什么问题?
回答公式:用户身份 → 使用场景 → 原来怎么解决 → 痛点 → 产品价值
核心用户是经常利用小长假、周末和朋友短途出游的在校大学生。他们预算敏感、经验不多、喜欢参考社交平台的攻略。原来的做法是自己刷攻略、拼行程,痛点有三个:信息分散且可能过期,交通时间和预算要自己算,计划一变就要整体重排。我的产品把「收集信息—排行程—控预算—动态调整」压缩成一次对话。我访谈了 [X] 位同学,最多人提到的是 【具体痛点】。
3. 为什么要做成 Agent,用 Workflow 不行吗?
回答公式:任务特点 → Agent 与 Workflow 的取舍 → 你的方案
如果只是「输入目的地,输出一份固定模板的攻略」,用 Workflow 就够了,而且更稳定。但旅行规划的难点在于变化:天气变了、景点闭馆了、用户说预算再砍 500,路径是事先画不完的。所以我用的是混合方案:预算计算这类确定性的环节走固定逻辑,行程的生成和调整交给 Agent,让它根据工具返回的信息自己决定下一步。
4. 你的 Agent 用的是什么范式?为什么?
主体是 Plan-and-Execute:先生成三天的行程框架,再逐天查询细节,这样结构清晰,用户也容易理解。遇到意外情况,比如查到某个景点当天闭馆,就用 ReAct 的方式局部调整,只改受影响的部分。纯 ReAct 在长行程里容易跑偏、Token 消耗也更高,所以最后选了这个组合。
(如果你真的对比测试过两种范式,一定要把对比结果讲出来,这会比任何理论解释都有说服力。)
5. 你怎么判断你的 Agent 做得好不好?
回答公式:评测维度 → 测试集 → 打分方式 → 迭代结果
我从结果、过程、效率成本、安全稳定四个维度做评测。结果看任务完成率,我把用户需求拆成否决型、核心型、一般型三类考点,加权计算得分;过程按输入、上下文、规划、执行四层设置指标,用来定位问题出在哪。测试集有 [50] 条,覆盖典型、边界和对抗场景。先人工标注,再搭建 LLM-as-Judge 做机评,和人工的一致率达到 [X]%。迭代 [3] 版后,任务完成率从 [X]% 提升到 [Y]%。
6. 讲一个你遇到的 Bad Case,你是怎么解决的?
回答公式:现象 → 定位到哪一层 → 根因 → 改动 → 验证
有一类案例是用户中途改了预算,Agent 输出的行程却还是按旧预算排的。我看了 Trace,发现规划环节本身没问题,问题出在上下文层:新旧两个预算同时留在上下文里,又没有标明哪个是最新的。我调整了上下文组装的逻辑,让用户修改过的要求覆盖旧值,再用同一批测试样本回归。这类问题的失败率从 [X]% 降到了 [Y]%。
7. LLM-as-Judge 你怎么保证它可信?
我做了几件事:第一,每个维度单独设一个评委,不让一个模型包办所有打分;第二,让评委打 0/1 分,而不是自由评价,并且允许它回答「无法判断」;第三,先用人工标注的样本做校准,一致率达标后才用机评;第四,对比两个版本时会交换先后顺序再评一次,避免位置偏差;第五,机评用起来之后也会持续人工抽检:每轮随机抽一部分机评结果人工复核,评委判了「无法判断」的样本全部交给人工看。一旦发现一致率下降,就回头调整评分规则和评委 Prompt。
8. 你不是计算机科班出身、代码也不强,怎么和研发合作?
我的优势不在写代码,而在把问题定义清楚。和研发沟通时,我会讲清楚:输入是什么、期望的输出是什么、哪里可能失败、用什么标准验收。做评测的经历让我习惯把问题定位到具体环节,比如「这是上下文没带上,不是模型能力不够」,这样研发能直接知道该改哪里。另外,我原来专业的训练让我习惯【举一个你专业带来的能力,比如拆解复杂系统、做实验设计、理解用户心理】,这在分析 Agent 链路时很有帮助。
(这里一定要换成你自己的背景。比如我是力学出身,就会讲力学训练出的拆解复杂系统的习惯。)
9. 效果不好的时候,你会考虑微调吗?SFT 和 RL 有什么区别?
我不会第一时间想到微调。一般先改 Prompt 和上下文,再用 RAG 补知识,这两步成本低、见效快。只有当输出格式或风格需要高度稳定、同类任务大量重复时,才考虑微调。SFT 是给模型看「输入 + 标准答案」的示范,让它模仿;RL 不给标准答案,而是给它打分,让它在试错中学会做得更好,常见的数据是同一个问题下两个回答的好坏对比,或者能用规则自动判断对错的任务。我做评测时定的考点和 LLM-as-Judge,其实和 RL 里的奖励是同一个思路:先把「什么算好」定义清楚。
八、想系统学 AI 产品,可以关注这些博主
读完这篇文章只是开始,AI 变化太快,最好的办法是找几个靠谱的信息源长期跟着。下面这 5 位都在 YouTube,内容以英文为主,可以开自动字幕。我按「先打底子、再懂原理、再看机会、最后跟前沿」的顺序排了一下,你可以按自己的阶段挑着看。
1. 吴恩达(Andrew Ng):帮你搭起 AI 学习框架
DeepLearning.AI 的创始人、Coursera 的联合创始人,也是很多人的 AI 启蒙老师。他最大的价值是帮你建立一个完整的认知框架:AI 能做什么、不能做什么,技术趋势在往哪走,企业到底怎么落地。完全零基础的话,可以从他的 AI for Everyone 开始,这门课就是给非技术背景的人讲的;之后 DeepLearning.AI 上有很多一两个小时的短课,Prompt、RAG、Agent 都有,很适合对照本文第二章去补。X:@AndrewYNg
2. Andrej Karpathy:把复杂的原理讲得人人能懂
OpenAI 创始成员之一,做过特斯拉的 AI 负责人,「Vibe Coding」这个说法也是他提出来的。他的长视频是我心目中最好的大模型科普:不用任何数学基础,也能听懂模型是怎么训练出来的、为什么会幻觉、Token 到底是什么。推荐先看 Intro to Large Language Models 和 Deep Dive into LLMs like ChatGPT,看完再回头读本文的预训练、SFT、RL 那部分,会理解得更透。X:@karpathy
3. Greg Isenberg:从产品和商业的角度看 AI
他的频道主要聊 AI 创业机会:有哪些产品方向值得做、怎么选市场、怎么赚钱,经常请做出小而美 AI 产品的独立开发者来拆解。这是 AI 产品经理最容易忽略的一块,懂技术之外,你还得判断一个产品为什么值得存在。想找自己的项目灵感,可以从他的 The Startup Ideas Podcast 看起。X:@gregisenberg
4. Matt Wolfe:最适合非技术背景的 AI 新闻和工具合集
他会定期汇总一周的 AI 新闻,测评各种新出的 AI 工具,讲得通俗,没有专业背景也能看懂。面试里常被问「最近用过什么 AI 产品、怎么评价」,跟着他看一阵子,你手里就会有足够多的产品样本。他还维护了一个 AI 工具导航站 Future Tools,可以当作找工具的入口。X:@mreflow
5. AI Explained:深入一点,看懂研究和技术前沿
这个频道会拆解新模型的发布、重要论文和各种评测基准,分析得比较深,也比较克制,不跟风吹捧。等你有了一点基础,想知道「这次新模型到底强在哪、评测分数可不可信」,就可以看他。顺便说一句,他看评测榜单的角度,对做评测的同学特别有启发。
写在最后
回头看,我找实习的起点其实很低:零实习,一个很简单的套壳项目,投了 500 多家才换来不到 20 次面试。
但我想说的是:AI 产品经理是少数真正「不限专业」的岗位之一。面试官看重的,是你能不能想清楚一个产品为什么存在、为谁存在,能不能判断 AI 做得好不好、该往哪里改。这些能力,靠方法和练习都能补上。
在 AI 的帮助下,每个人都能做出自己的产品,哪怕一行代码都不会写。
希望这篇文章能帮你少走一些弯路。如果你也在准备 AI 产品岗,欢迎在评论区聊聊你卡在哪一步。
推荐关注 / 致谢
这篇文章的结构参考了夏林果老师(@momo_peggy)的《零出海经验,如何拿到 AI 出海产品&运营 offer?附跟练&面试真题》,在此特别感谢。
如果你对 AI 出海方向感兴趣,非常推荐去看看她的这篇文章。它从出海岗位的 JD 拆解讲起,把 AI 出海产品岗和海外增长运营岗的区别、跟练项目和面试真题都讲得很清楚,和这篇正好可以互补:一篇讲怎么做好 AI 产品本身,一篇讲怎么把 AI 产品带到海外市场。https://x.com/momo_peggy/status/2104854926535073885?s=20
参考资料
- OpenAI:Agent evals 指南,https://developers.openai.com/api/docs/guides/agent-evals
- Anthropic:Demystifying evals for AI agents,https://www.anthropic.com/engineering/demystifying-evals-for-ai-agents
- Google Cloud:A methodical approach to agent evaluation,https://cloud.google.com/blog/topics/developers-practitioners/a-methodical-approach-to-agent-evaluation
本文提及与引用
原文提到的内容里,已在本站整理好的可以直接接着读;标注「原文来源」的还没有整理成站内文章。
- 零出海经验,如何拿到 AI 出海产品&运营 offer?附跟练&面试真题链接 · 已采集入库,待审核通过后自动挂上链接
内容核验说明
从 BOSS 直聘 5 条真实 JD 反推 AI 产品岗的能力分层,再用一个旅行规划 Agent 把概念、搭建、评测串成可照着走的流程;四层链路归因、考点加权算完成率、pass^k 测稳定性,都是别处少见的可操作细节。适合想转岗的在校生,以及传统产品、运营、设计。作者的经历和数字均来自其自述,诀.com 未独立验证,简历上的指标要自己跑出来。
文中投递数量、面试家数、任务完成率与 pass^k 提升等数据均为原作者自述,诀.com 未独立验证;评测章节参考了 OpenAI、Anthropic、Google 公开文档,链接由作者给出,本站未逐条核对;简历与面试示范中的方括号数字属于占位模板,不是已跑出的结果。评论区整合
根据评论整合来看,多数回复在称赞作者的执行力和毅力,认为零实习投 500 多家、最后拿到字节 AI 产品实习,这个转化率含金量高;也有人认可 JD 拆解加 Agent 跟练是当下 AI 产品岗的标配。补充经验方面,有人回忆早年实习门槛低、基本点击就送,并感慨如今中大厦硕也要海投;有人认为现在找实习要靠作品说话,比十年前高了不少。另有回复问是否在 BOSS 直聘投递,并分享自己首投 30 多家无人回复、重新投递后陆续收到回复,觉得平台像需要养号。还有人提到自己招聘时最看重候选人如何定义观测指标。
基于原帖公开评论整理,只反映讨论中的观点与反馈,不代表诀.com 立场。原始来源
原作者:Leo(@double_burger_2)
本文对公开来源内容进行了结构化整理,原观点与内容归原作者所有。
查看原文