图解大语言模型部署
文章把自部署大模型时要盯的指标分成延迟、吞吐、资源、服务质量、成本五类,逐一说明定义、参考区间与常见误解,包括 TTFT 与 Prefill Time 的区别、TPOT/ITL 统计口径、P95/P99 尾部延迟、显存与 KV cache 计算、量化损失、成本与 TCO 等。后半部分以 DGX Spark 上 Ling-3.0-flash-INT4 的实测数据为例,给出并发扩展、KV cache 超配、长上下文降速、投机采样统计口径与质量评测中的具体数字和排坑提示,并附硬件选型对照表和常用压测、监控工具与链接。
前言
自部署大模型时,你真正需要关心的指标可以归纳为一句话:首字够不够快(TTFT),字出来够不够连贯(TPOT/ITL),并发多了吞吐掉不掉(系统吞吐),显存能不能装下且留有余量(VRAM + KV cache),每一百万个token的实际成本是多少(cost per M tokens)。
本文适合哪些人读:
- 搞懂不同参数量对显存与带宽的真实要求,避免买错配置
- 针对 RAG、长文档、Agent 等业务场景挑选适配模型与量化版
- 排查高并发吞吐瓶颈、出字卡顿与长上下文严重掉速
- 定位 TTFT 飙升、P99 抖动、显存超配与假死 OOM
- 核算每百万 Token 真实 TCO,评估自建与商业 API 的划算临界点
阅读指南:
- 如果你正准备选购硬件或评估成本:第四节(显存计算)、第六节(成本核算) 与 第八节(硬件选型对照)
- 如果你正在调优性能或排查吞吐瓶颈:第二/三节(延迟与吞吐)、第七节(进阶优化) 与 第九节(真机实测避坑)
- 如果你正在为特定业务(RAG / Agent / 对话)做技术选型,搭建测试工具链与监控体系:第十节(常用实测与监控工具)
- 如果你的模型服务即将上线生产:第五节(服务质量与探针)
一、先看实际案例
我们以7月底新出的 Ling-3.0-Flash 为例,这是一个 MoE 架构模型。和 Qwen 3.8 27b 这类稠密模型不同的是,MoE模型一个典型特点是,模型参数和激活参数不一致,总参数 124B,每 token 仅激活约 5.1B,定位为高性价比、面向生产级 Agent 的快速执行层,价格仅为Qwen 3.8 27b的一个零头。
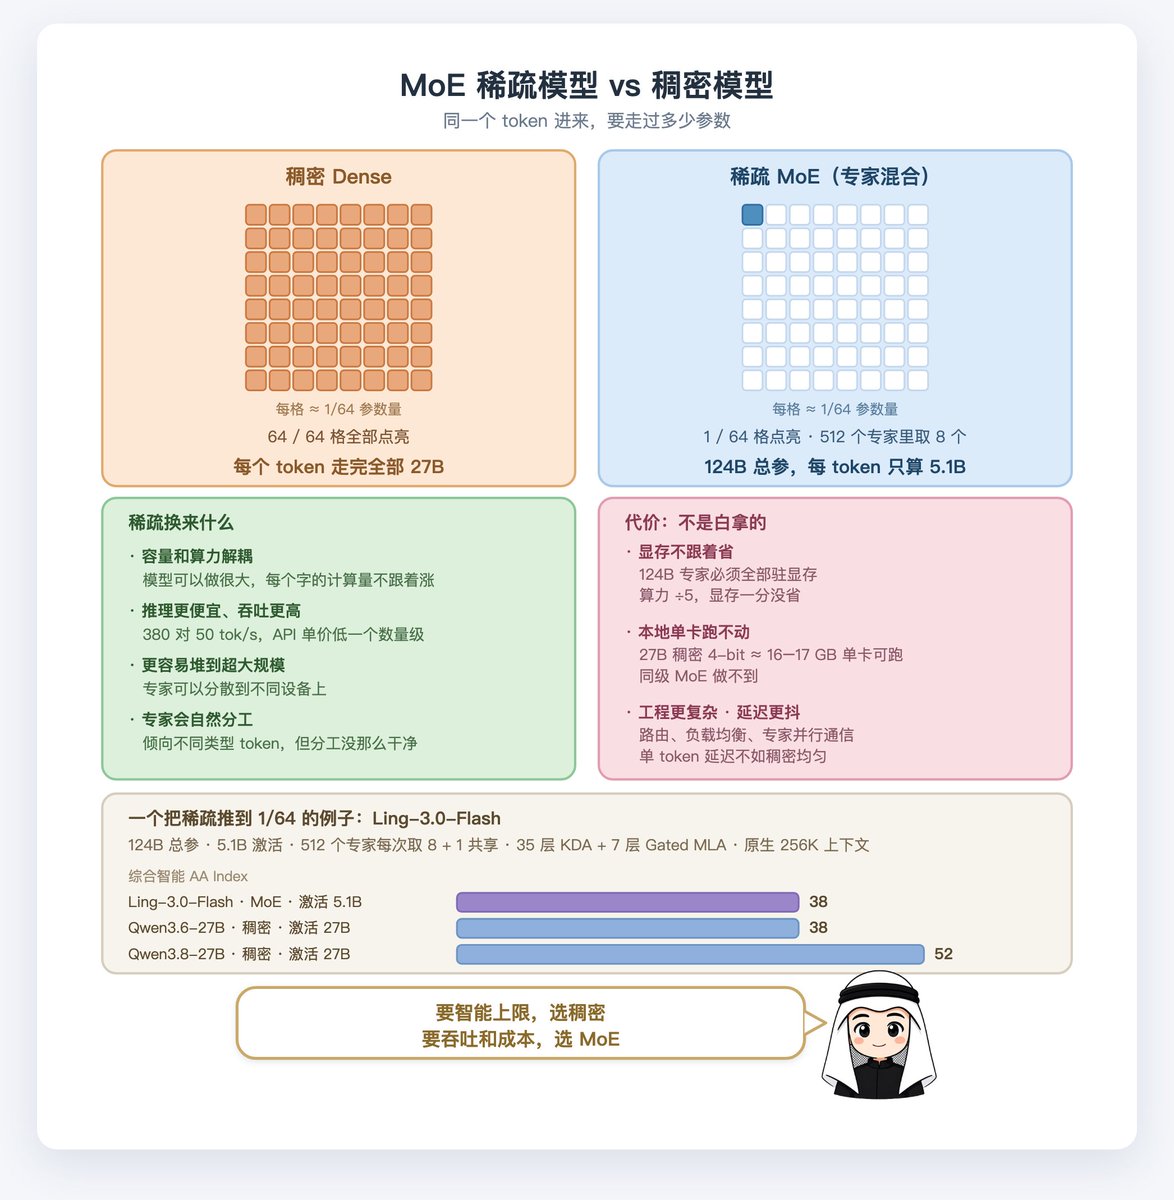
实际部署中,同一个模型换个负载或上下文长度,吞吐与延迟可能相差数倍。本节以一台真实服务器的完整测量为例,把各项指标落地为具体数字。
测试环境与被测对象
- 硬件平台:NVIDIA DGX Spark(GB10 Grace-Blackwell),121 GB 统一内存(CPU/GPU 共用内存空间,无额外系统内存缓冲)
- 被测模型:Ling-3.0-flash-INT4(124B MoE / 5.1B 激活,KDA+MLA 混合注意力)
- 推理引擎:vLLM(开启 CUDA Graphs 与 MTP 投机解码),
--max-model-len 16384 - 统计口径:统一按 API 返回的
usage.completion_tokens计数
- 单请求 TTFT:215 ms,短 Prompt 真实计算与传输延迟
- 高并发 TTFT:20.7 s(20 请求并发),绝大部分时间在队列中等待调度,非模型计算慢
- 单流 Decode 速度:39.4 tok/s,稳定出字速度
- 高并发聚合吞吐:242.1 tok/s,16 并发饱和运行时的系统产出
- 显存与冷启动:权重常驻 71.7 GiB,总占用 103/121 GB,冷启动约 8 分钟(引擎初始化 49.8 s)
初次看到TTFT、单流 Decode 速度、高并发聚合吞吐、显存与冷启动这些术语,想必大家都会和我一样云里雾里。好消息是,看完这篇文章,你将能树立起一个端侧模型部署的一个全面认识。
二、延迟类指标(用户感知最直接)
1. Prefill Time(预填充时间)
大模型推理分两个阶段:
- Prefill(预填充):一次性处理你输入的整段提示词(prompt),做注意力计算的前向扫描。这一阶段是计算密集的——GPU 的算力跑满
- Decode(解码):逐个字/token 生成回复。这一阶段是访存密集的——GPU 在等显存里的数据搬过来,算力常常只用到一小部分
Prefill Time 就是模型读完整段 prompt 到开始产出第一个字在系统内部所花的时间。它直接影响 TTFT 的大小,所以常被一起提及,但两者定义不同(见下)。
2. TTFT(Time to First Token,首字延迟)
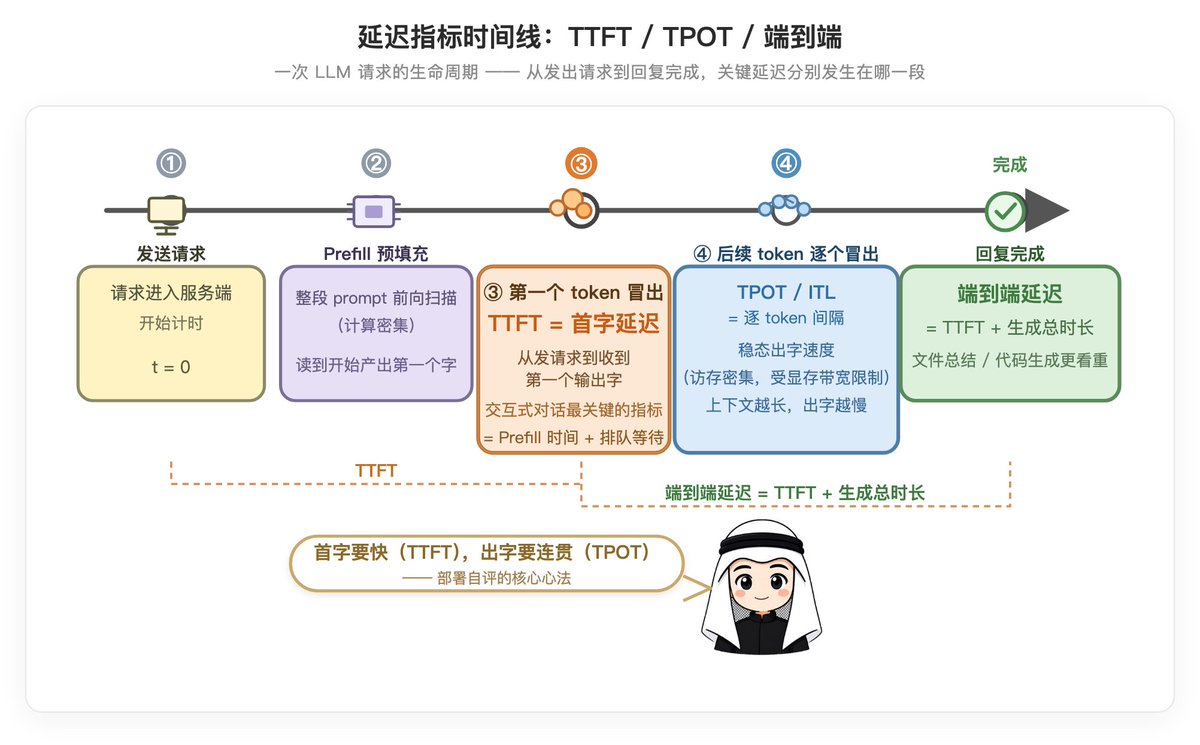
定义:从请求发送到服务端,到收到第一个输出 token 的时间。
这是交互式对话场景最关键的延迟指标,直接对应问完问题后要多久能看到第一个字冒出来。一个 70B 模型在单卡 H100 上,短 prompt 的 TTFT 一般在 几百毫秒到两秒;长 prompt(几万字)会显著上升。
注意 TTFT = Prefill Time + 排队等待时间。如果系统很忙、你的请求要排队,TTFT 里很大一部分其实是排队,而不是模型计算慢。
3. TPOT / ITL(逐 token 间隔,即解码延迟)
连续两个词之后,字是一个接一个蹦出来的,这个蹦字速度有两个常用统计口径:
- ITL(Inter-Token Latency):每个 token 之间的时间间隔(逐 token 取样后统计,可分 P50/P95/P99)
- TPOT(Time Per Output Token):整段回复中,从第一个 token 到最后一个 token 的总时长 ÷ 输出 token 数(平均值)
业界文档和基准测试(如 MLPerf Inference、vLLM/SGLang 社区)主要用 TTFT + TPOT。它们描述的是稳态出字速度,不关心首字,也不关心输入多长。一个在单卡 H100 上跑 INT4 量化 70B 模型的常见区间是 50~120 tokens/秒(即每个 token 约 8~20 毫秒),具体随上下文长度而变。
重要规律:解码阶段受显存带宽限制,出字速度会随着上下文变长而下降(因为 KV cache 越来越大,每次都要搬更多数据)。这是自部署必须知道的长上下文减速现象。
这个下降比多数人预期的要早、也要陡。第九节有一条实测曲线:同一台机器同一个模型,prompt 从 300 token 涨到 15K,decode 从 39.0 掉到 18.2 tok/s——在 16K 窗口内部就已经腰斩,放到 49K 则是 7.1,慢 5.6 倍。
4. 端到端延迟与分位数(P95 / P99)
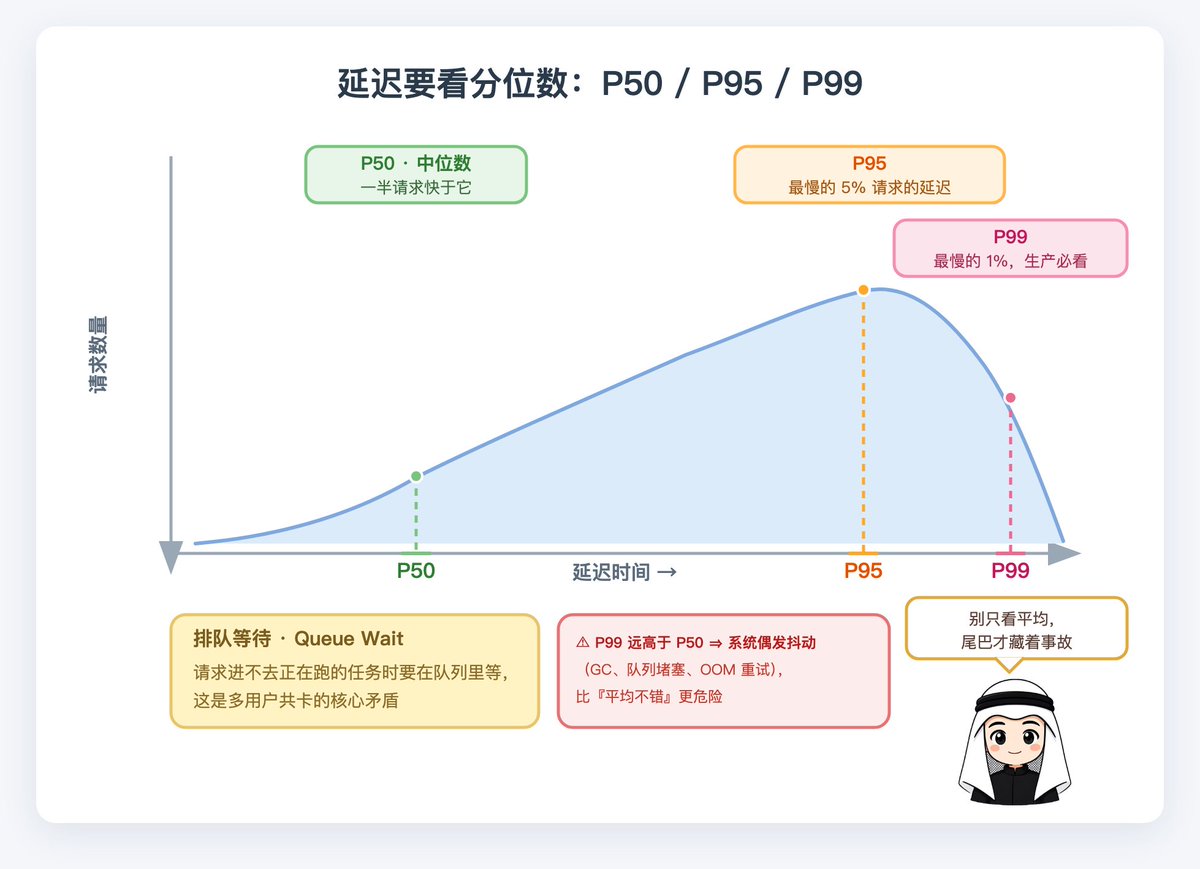
- 端到端延迟(End-to-End Latency):从发送请求到收到全部回复的时间,等于 TTFT + 生成总时长,对文件总结、代码生成这类任务更重要
- P95 / P99 延迟:不是只看平均值!平均值会掩盖尾部异常。P95=慢的那 5% 请求的最差延迟,P99=慢的 1%。生产环境看性能,一定要看 P95/P99 而不是均值。如果 P99 远高于 P50,说明系统偶发抖动(GC、队列堵塞、OOM 重试),这比平均值更值得重视
三、吞吐类指标(系统能扛多少活)
1. tokens per second(TPS,每秒 token 数)
最常见也最容易误解的指标。必须分清三个不同口径:
- 整体 TPS:系统每秒钟生成的总 token 数(输入+输出合并或只看输出,要看报告怎么定义)
- Prefill throughput:预填充阶段的吞吐,对读长文档类任务重要
- Decode throughput:解码阶段的吞吐,对对话类任务重要;常与单卡最大 TPS 挂钩
单卡 H100 上,70B INT4 模型的 decode 吞吐上限大概在 100+ tokens/s;7B 小模型在消费级 4090 上可以达到 200 tokens/s 以上(因为小模型计算占比高,更吃算力而非带宽)。
2. Requests per second(QPS,每秒请求数)
衡量同时能服务多少路对话。交互场景下,一个 QPS 往往对应几十路并发对话。QPS 和 TPS 的关系取决于并发度:10 路对话 × 每路 50 tok/s = 系统 500 tok/s。
3. 连续批处理(Continuous Batching / Chunked Prefill)的效果
早期推理框架用静态批处理:必须等一批请求全部生成完才下一批,GPU 在等人想问题时空转,吞吐掉得厉害。现代框架(vLLM 的 continuous batching、SGLang、TGI)在 token 间隙就插入新请求,让 GPU 不空转。
评估这个优化是否生效的关键指标是:同等显存下,并发数提升时系统吞吐是否还能线性增长。没有连续批处理的系统,并发一高 TPS 就断崖下跌;有的话可以顶住几十上百并发。
但断崖有两种,画出来的曲线一模一样:一种是连续批处理没生效,另一种只是 --max-num-seqs 之类的并发槽位上限卡住了队列。第九节 2 把同一台机器的两条曲线并排放在一起——同一个 8 并发,一条 104.9 tok/s 且 TTFT 涨 24 倍,另一条 167.9 tok/s,差别只在一个参数。看到断崖先去查槽位,再去怀疑框架。
4. 系统吞吐 vs 单机吞吐
多卡部署时要看线性扩展效率:N 张卡 ≈ N 倍吞吐?实际常因通信开销打 7~9 折。衡量标准是 效率比 = 实测多卡吞吐 ÷ (单卡吞吐 × 卡数)。低于 0.7 说明并行策略或互联(NVLink/PCIe)成了瓶颈。
四、资源类指标(你的机器吃得消吗)
1. VRAM 显存占用(能否装下是第一道门槛)
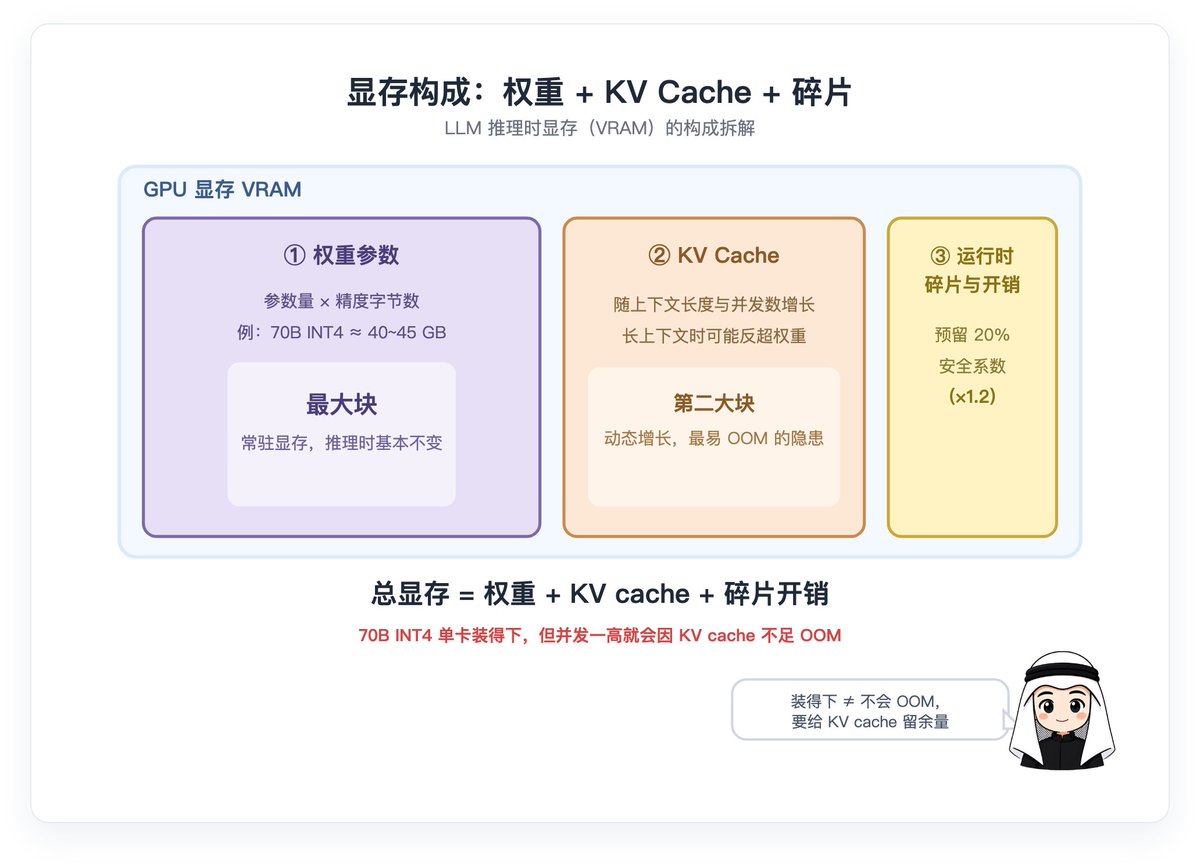
总显存 = 权重参数占的显存 + KV cache 占的显存 + 运行时碎片开销。
- 权重占用的粗略算法:参数量(十亿)× 精度字节数。BF16/FP16 每个参数 2 字节,INT4 约 0.7 字节(含少量元数据按 0.75 算)
常见区间参考:
- 7B:FP16/BF16 约 14 GB,FP8 约 7–8 GB,INT4 (AWQ/GPTQ) 约 5–6 GB
- 30B:FP16/BF16 约 60 GB,FP8 约 32 GB,INT4 (AWQ/GPTQ) 约 18–20 GB
- 70B:FP16/BF16 约 140 GB(+碎片≈150+ GB),FP8 约 72 GB(+碎片≈90 GB),INT4 (AWQ/GPTQ) 约 40–45 GB
- 7B(128K 上下文 KV cache 单独算):见下方 KV cache 速查
经验法则:算完理论值后乘以 1.2 的安全系数预留 KV cache 和碎片空间。70B INT4 单卡装得下,但并发稍高就会因 KV cache 不足 OOM,这正是为什么能安装,但是运行过程中还会挂的原因。
2. KV Cache 计算公式(上下文越长越吃显存)
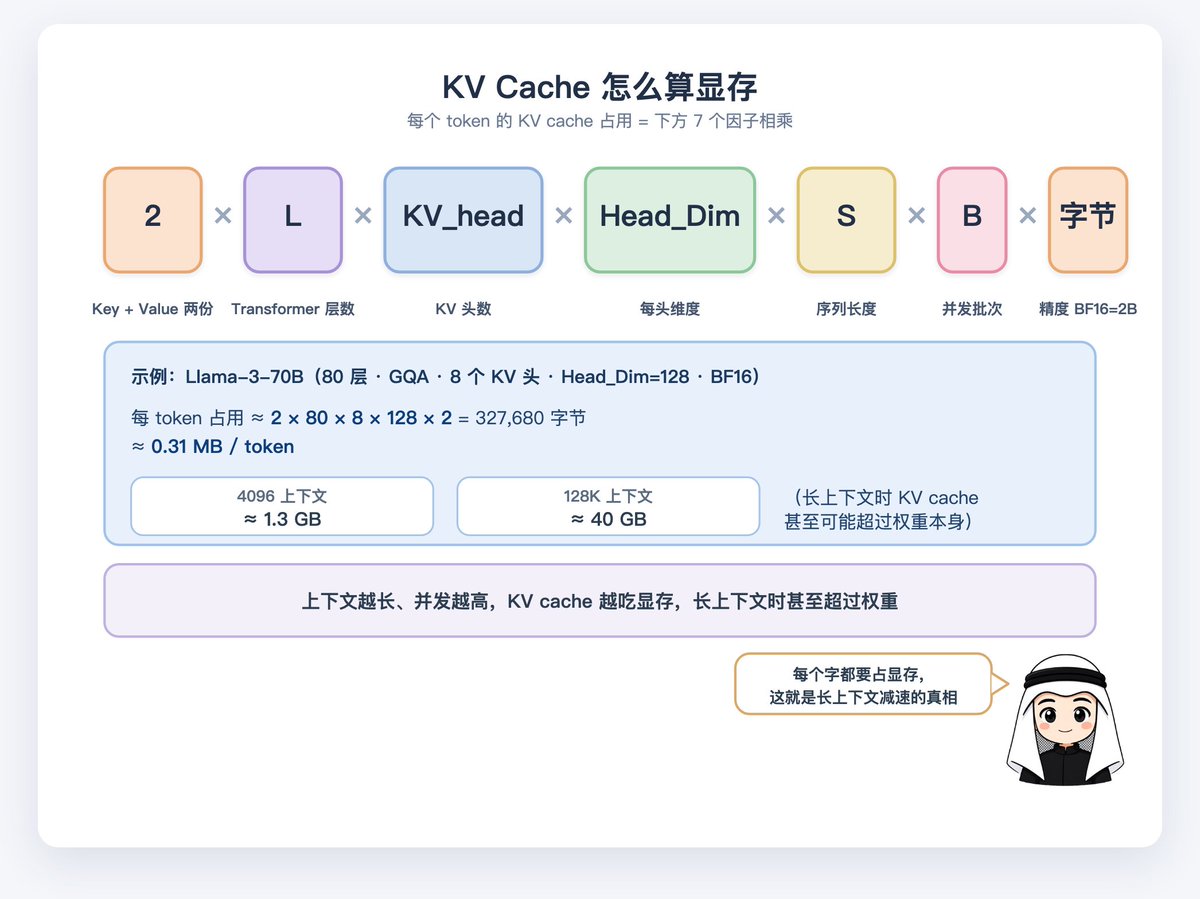
KV cache 是把注意力计算结果缓存起来,避免重复计算——上下文窗口越大、并发越高,占的显存越多。通用公式:
KV cache 字节数 ≈ 2 × L(层数) × K_v_head_数量 × Head_Dim × 序列长度(S) × 批次(B) × 精度字节数其中 2 代表 Key 和 Value 两份缓存。以 Llama-3-70B 为例(80 层、GQA、8 个 KV head、head_dim=128、BF16 即 2 字节):
- 每 token 约 2 × 80 × 8 × 128 × 2 = 327,680 B ≈ 0.31 MB/token
- 4096 长度 → 约 1.3 GB;128K 长度 → 约 40 GB
这意味着:长上下文(≥32K)+ 多并发时,KV cache 可能超过权重本身,成为显存的第一瓶颈。也是为什么很多部署会把长上下文的 KV cache 做量化(KV quantization)或卸载到 CPU。
反方向的错误同样常见,而且更隐蔽:按最大上下文 × 最大并发把 KV 池开满,实际只用到百分之几。第九节 3 是一个超配 24 倍的实测(池子 1,098,590 token,实际在用约 46,000,GPU KV cache usage 4.2%);把这个参数调下来之后,腾出的内存换来了更高的聚合吞吐。--gpu-memory-utilization 在配方里通常是为装得下而配置的,并不是为跑得又好又稳而配置,抄配方的时候这个点值得注意。
3. GPU 利用率与显存带宽利用率
- GPU 利用率(%):计算单元(SM)被占用的比例。解码阶段即使利用率只有 30% 也可能是正常的(因为卡在显存带宽上)——不能单靠利用率高低下结论
- 显存带宽利用率:LLM 解码通常是访存密集,这才是决定出字数度的真实瓶颈。对比硬件时要看 带宽(GB/s):H100 SXM 约 3 TB/s、H200 约 4.8 TB/s、A100 约 2 TB/s、RTX 4090 约 1 TB/s。带宽差几倍,同样模型的出字速度就差几倍
4. 精度与量化损失
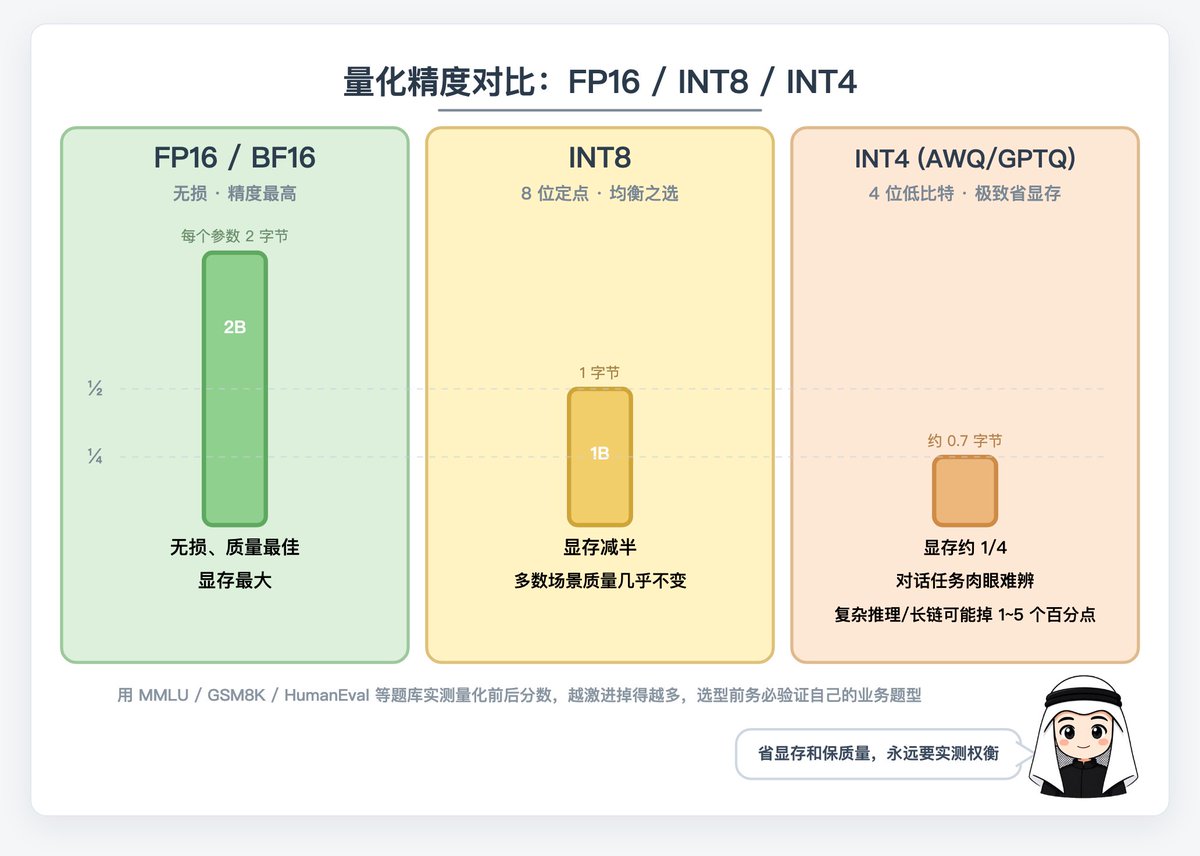
- FP16/BF16:无损、质量最佳,但显存翻倍,解码偏访存瓶颈
- INT8:显存减半,多数场景质量几乎不变
- INT4(AWQ/GPTQ):显存变为 1/4,对话类任务通常肉眼难辨差异,但在复杂推理/长链思考任务上可能有 1~5 个百分点的质量下滑
量化失真指标:用权威题库(MMLU、GSM8K、HumanEval、MAUSt 等)跑量化前后对比分数,量化越激进分数掉得越多。选 INT4 前一定要实测自己业务相关题型的跌落。
五、服务质量与可靠性指标(生产环境才真正重要)
1. P95/P99 延迟与排队等待时间(Queue Wait Time)
即使纯计算延迟很快,也要看排队时间——请求进不去正在跑的任务,要在队列里等多久。这是多用户共卡时的核心矛盾:单路很快,人一多大家都慢。
监控面板建议:TTFT-P50/P95、TPOT-P50/P95、排队时间-P50/P95,分别看。
2. 错误率与 OOM 频率
- OOM(Out of Memory)重试会让偶发请求延迟爆炸,是 P99 抬头的常见原因
- 指标:错误率(含超时、OOM、格式解析失败)、重试次数、parsing error rate
/health 返回 200 不代表引擎在出字。多数推理框架的健康检查探的是 API server,而真正干活的是它背后的引擎进程——两者可以分开死。存活探针要探一次真实生成(发一个 1 token 的请求看有没有回来),不能只探端口或探进程。
但判活条件不能用请求超时。一个会排队的系统里,满负载时请求本来就该等——用超时判活,等于让流量高峰去重启你的服务。判活看的应该是引擎还在不在推进(比如引擎日志里的 Avg generation throughput 是否连续多个采样周期为 0),不是单个请求快不快。
3. 可用性(Availability / Uptime)
- 服务正常对外可用时间的百分比(99.9% ≈ 每月不到 44 分钟不可用)
- 配合健康检查(health check)和优雅重启,避免因一次 OOM 把整个进程搞死
4. 超时配置与流式(Streaming)体验
推荐开启流式输出:字出来了就边写边返回给用户,用户不用等整段生成完,感知延迟接近 TTFT。同时要设合理的 request timeout,防止单个超长请求卡死连接。
六、成本类指标(钱花得值不值)
1. Cost per token(每个 token 的成本)
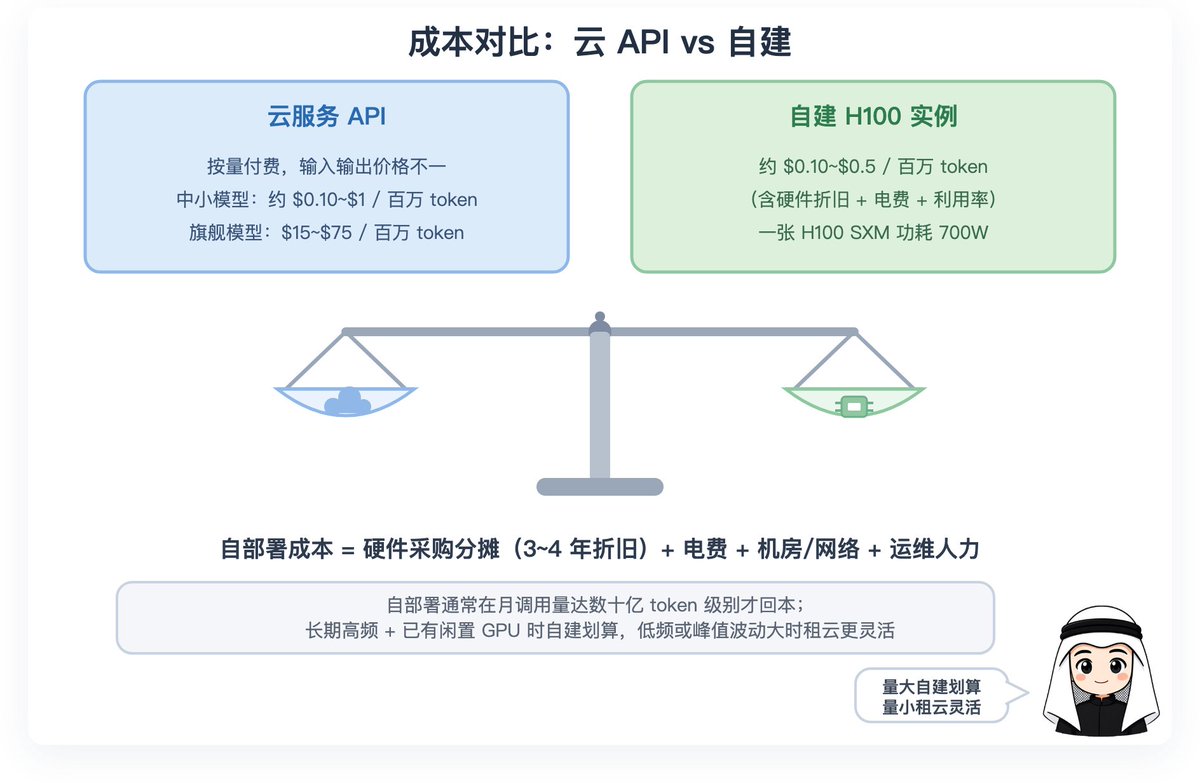
最直观的对比口径:
- 云服务 API:中小模型约 $0.10~$1/百万,旗舰模型 $15~$75/百万(输出 token)
- 自建 H100 实例:约 $0.10~$0.5/百万(取决于硬件折旧+电费+利用率)
注意 API 价格输入输出还不一样,对比时要统一口径。自部署通常在月调用量达到数十亿 token 级别时才回本,取决于你的硬件购置成本和电费。
2. Tokens per dollar(每美元产出 token 数) & tokens per kWh
用于横向对比不同硬件的效率,尤其是买哪块卡、还是直接租云。
自建时还要把电力消耗算进去(一张 H100 SXM 功耗 700W,4090 约 450W),tokens/kWh 高的方案长期更省钱。
3. 硬件折旧与 TCO(总拥有成本)
自部署的成本 = 硬件采购分摊(3~4 年折旧)+ 电费 + 机房/网络 + 运维人力。短期高频调用且团队已有闲置 GPU 时自建划算;低频或峰值波动大的场景,租云更灵活。
七、进阶优化技术的专属指标
这些是你调优时的手感表,开了优化就要盯这些数据:
1. Speculative Decoding(投机采样 / 草稿验证)
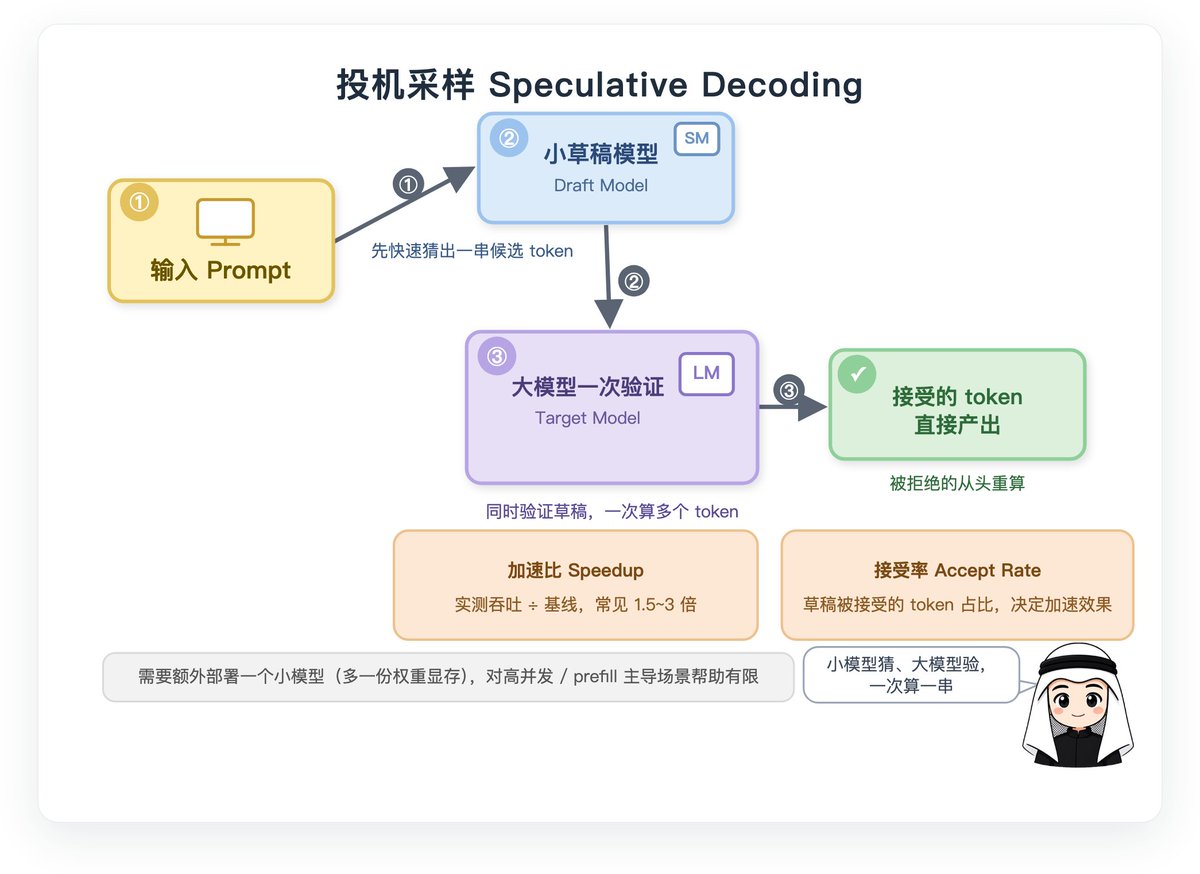
用小草稿模型先猜一串 token,再由大模型一次验证。
关键指标:
- 加速比(Speedup):实测吞吐 ÷ 基线吞吐,常见 1.5~3 倍(解码瓶颈、中低并发时最明显)
- 接受率(Accept Rate):草稿被大模型接受的 token 占比,决定加速效果;草稿模型越接近目标模型,接受率越高
代价:需要额外部署一个小模型(多一份权重显存),且对高并发、prefill 主导的场景帮助有限。
测量陷阱(这条比前两条更容易踩):开了投机采样后,按 SSE chunk 数算 tok/s 会系统性低估——被接受的草稿 token 和验证它的 token 挤在同一个 chunk 里。第九节 5 里这个错误把实际的 41 tok/s 报成了 20.5,而 20.5 几乎正好等于关掉投机采样的参考值,看起来完全可信。正确做法:stream_options: {"include_usage": true},读 usage.completion_tokens。
2. Prefix Caching(前缀缓存 / Prompt Caching)
把 prompt 中公共的前几个 token 已算好的 KV cache 存起来复用(比如同一份系统提示词、同一份长文档)。
关键指标:
- 命中率(Hit Rate):命中时该部分 Prefill 被跳过。真实业务(Agent 场景、RAG 固定文档)可达 50%~70%
- 延迟降低幅度:命中时该请求的 Prefill 可降到 1/x,整体 TTFT 可下降 40%~90%;但全不命中时反而略增开销
注意缓存有生命周期管理,命中率太低说明你的场景前缀重复度低,这项优化不划算。
3. 量化失真(Quantization Quality Degradation)
如前所述,用 MMLU/GSM8K/HumanEval 等分数衡量 INT8/INT4 带来的质量损失,确保在可接受范围内。
4. 多卡并行扩展效率(Parallelism Scaling Efficiency)
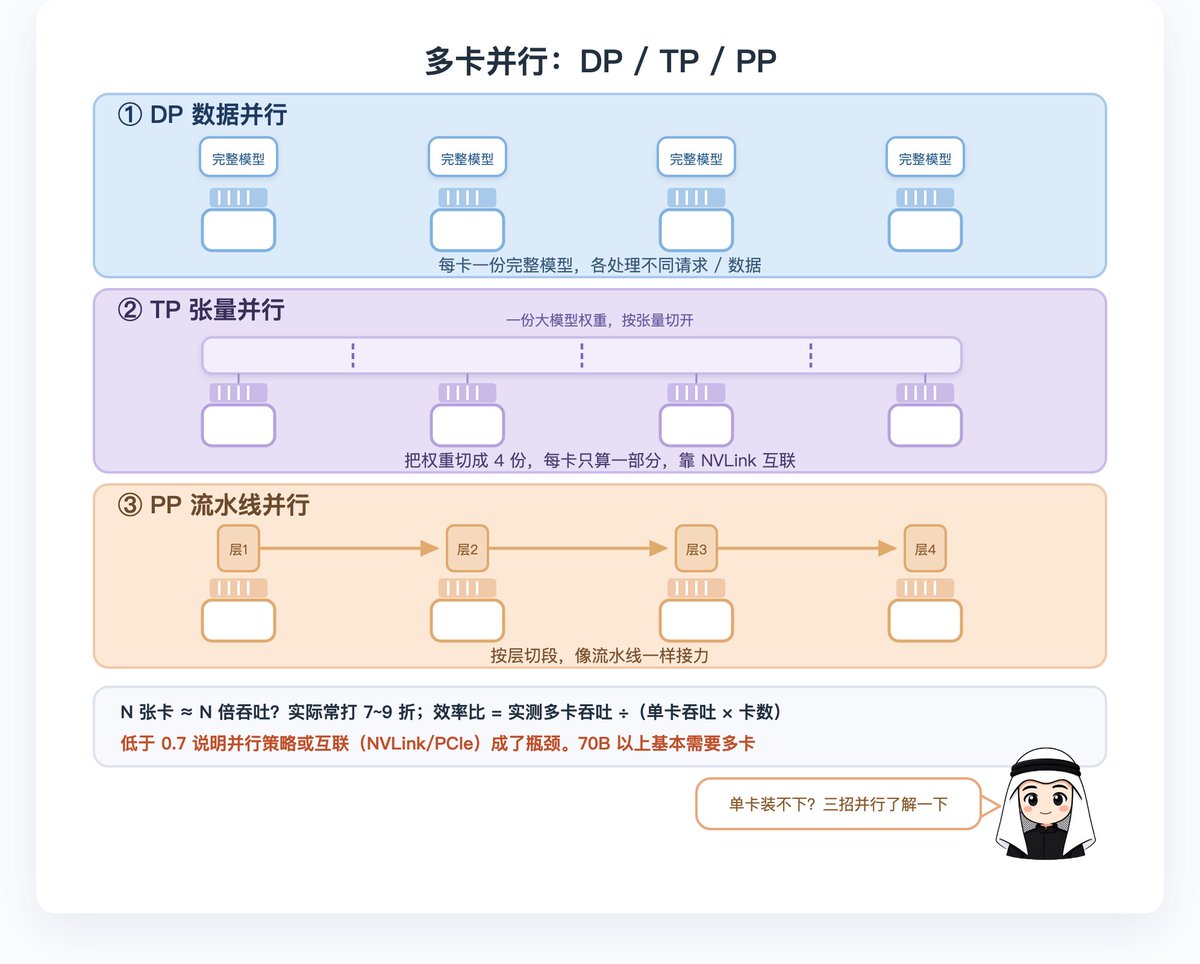
- 单卡放不下时要用 DP(数据并行复制)/TP(张量并行切分权重)/PP(流水线并行)
- 指标:前述线性扩展效率比;多卡时还要看通信开销占比(NVLink 机型优于 PCIe),70B 以上模型基本需要多卡
5. Long-context 专项指标
长上下文部署额外关注:KV cache 占比(占总显存的%)、长文解码降速比例(2K vs 32K 时 TPS 掉多少)、以及是否启用了 KV cache 量化/卸载、FlashAttention、PagedAttention 等显存优化技术。
八、真实硬件参考值与选型对照
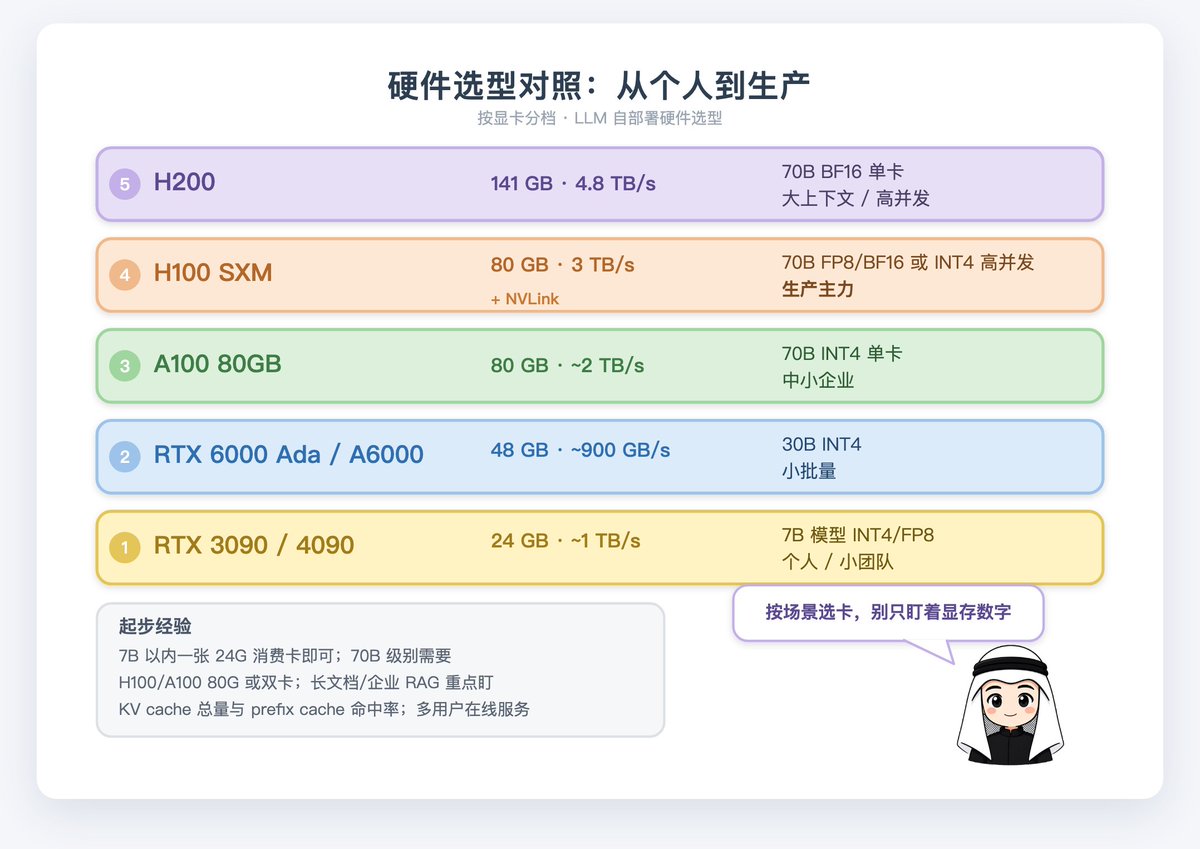
- RTX 3090/4090:显存 24 GB,带宽 ~1 TB/s,适用 7B 模型 INT4/FP8,个人/小团队
- RTX 6000 Ada / A6000:显存 48 GB,带宽 ~900 GB/s,适用 30B 模型 INT4,小批量
- A100 80 GB:显存 80 GB,带宽 ~2 TB/s,适用 70B INT4 单卡,中小企业
- H100 SXM (80G):显存 80 GB,带宽 3 TB/s + 900 GB/s NVLink,适用 70B FP8/BF16 或 INT4 高并发,生产主力
- H200:显存 141 GB,带宽 4.8 TB/s,适用 70B BF16 单卡 / 大上下文 / 高并发
- H20(出口特供):显存 96 GB,低算力、带宽一般,适用 70B INT4 单卡,预算受限场景
自部署的起步经验:
- 7B 以内:一张 24G 消费卡即可,优先看 TPOT 和 QPS
- 70B 级别:需要 H100/A100 80G 或双卡 A800/H20;INT4 能省显存但要做质量验证
- 长文档/企业 RAG:重点盯 KV cache 总量、prefix cache 命中率、长上下文降速
- 多用户在线服务:重点盯连续批处理、P95/P99、排队时间和 OOM
九、实测样本:Ling-3.0-Flash 真机测量
前面的章节给出了各项指标的定义与参考区间。但实际部署中,同一个模型换个负载或上下文长度,吞吐与延迟可能相差数倍。本节以第一节中一台真实服务器的完整测量为例,把各项指标落地为具体数字。
测试环境与被测对象
- 硬件平台:NVIDIA DGX Spark(GB10 Grace-Blackwell),121 GB 统一内存(CPU/GPU 共用内存空间,无额外系统内存缓冲)
- 被测模型:Ling-3.0-flash-INT4(124B MoE / 5.1B 激活,KDA+MLA 混合注意力)
- 推理引擎:vLLM(开启 CUDA Graphs 与 MTP 投机解码),
--max-model-len 16384 - 统计口径:统一按 API 返回的
usage.completion_tokens计数
1. 延迟与吞吐:区分计算耗时与排队耗时
- 单请求 TTFT:215 ms,短 Prompt 真实计算与传输延迟
- 高并发 TTFT:20.7 s(20 请求并发),绝大部分时间在队列中等待调度,非模型计算慢
- 单流 Decode 速度:39.4 tok/s,稳定出字速度
- 高并发聚合吞吐:242.1 tok/s,16 并发饱和运行时的系统产出
- 显存与冷启动:权重常驻 71.7 GiB,总占用 103/121 GB,冷启动约 8 分钟(引擎初始化 49.8 s)
核心结论:监控报警 TTFT 飙升时,先看系统并发队列和排队耗时,不要盲目归咎于模型算力不足。
2. 并发扩展:识别假性吞吐断崖
- 并发数 1:限制槽位(
seqs 4)聚合吞吐 37.1 tok/s;放开槽位(seqs 16)聚合吞吐 36.3 tok/s - 并发数 4:限制槽位 106.6 tok/s;放开槽位 92.3 tok/s
- 并发数 8:限制槽位 104.9 tok/s(TTFT 暴增至 5.2s);放开槽位 167.9 tok/s
- 并发数 16:放开槽位 242.1 tok/s
假性断崖:在 seqs 4 配置下,8 并发时吞吐不再增长且延迟暴增,看似是连续批处理失效,实则是服务端参数限制了并发槽位。
扩展代价:从 1 并发扩至 16 并发,总吞吐提升 6.7 倍(36.3 → 242.1 tok/s),但单请求出字速度从 36.3 降至 15.1 tok/s。单机部署需在单流体验与系统吞吐间权衡。
3. KV Cache 显存陷阱:过犹不及的超配
按照常规经验将 --gpu-memory-utilization 设为 0.80 时,分配了 21 GiB 的 KV Cache 池(约 110 万 Token)。但在实际跑 4 路复杂请求时,仅使用了约 4.6 万 Token(利用率仅 4.2%,显存超配 24 倍)。
utilization 0.80/seqs 16:单流速度 28.7 tok/s,16 路聚合吞吐 226.8 tok/s,剩余可用显存 18 GB,KV 池大小 20.8 GiButilization 0.70/seqs 16:单流速度 36.3 tok/s,16 路聚合吞吐 242.1 tok/s,剩余可用显存 30 GB,KV 池大小 9.67 GiB
核心结论:盲目把 KV 池开满会挤占系统运行缓冲。若监控中 GPU KV cache usage 长期处于个位数,主动调低利用率参数,可释放多达 12 GB 显存,且吞吐与单流速度反而更优。
4. 长上下文降速曲线:Prefill 与 Decode 走势完全相反
在大海捞针(Needle In A Haystack)长文本实测中(生成 128 Token):
- Prompt 269 token:Prefill 速度 838 tok/s,TTFT 0.32 s,Decode 速度 39.0 tok/s
- Prompt 2,971 token:Prefill 速度 2,441 tok/s,TTFT 1.22 s,Decode 速度 32.4 tok/s
- Prompt 10,815 token:Prefill 速度 2,693 tok/s,TTFT 4.02 s,Decode 速度 20.5 tok/s(接近腰斩)
- Prompt 14,738 token:Prefill 速度 2,671 tok/s,TTFT 5.52 s,Decode 速度 18.2 tok/s
- Prompt 49,000 token:Prefill 速度 2,429 tok/s,Decode 速度 7.1 tok/s(慢 5.6 倍)
Prefill 保持恒定:从 3K 到 49K Token,Prefill 速度稳定在 2,400+ tok/s(混合线性注意力架构优势明显)。
Decode 持续衰减:随着上下文拉长,每一步搬运 KV Cache 的访存开销剧增,在 11K 附近速度即已腰斩。
避坑要点:评测长文本性能时,必须将测点放在上下文窗口中段(如 8K~16K),切忌只测首尾两端,也不要把 Prefill 不掉速误当成 Decode 不掉速。
5. 投机采样:识别客户端统计陷阱
加速上限受限于接受长度:实测 MTP 接受率为 65.4%,平均单次验证吐出 1.65 个 Token,加速收益上限约为 1.6 倍。
统计陷阱:开启投机采样后,多个被接受的 Token 会合并在同一个 SSE Chunk 中返回。若在客户端单纯按 Chunk 数量计算速度,会测出 20.5 tok/s 的假数据(误以为投机采样失效);正确做法是读取响应中的 usage.completion_tokens,实际速度为 41 tok/s。
6. 质量评测:指标解读的两大盲区
思维链截断陷阱:在 IFEval 评测中,开启思考模式后得分从 0.789 骤降至 0.207。排查发现是由于 max_tokens 设为 2048,导致思维链未完成即被强制截断。输出上限配置不足在质量测试中表现为分数低,而非直接报错。
工具调用(Function Calling)须看分层表现:BFCL-v3 综合得分 0.744,但拆解后:单轮调用为 0.887(足以支撑生产),而多轮自主循环仅为 0.438。在构建 Agent 系统时,应由外层工作流编排驱动,而非完全依赖模型的长链自主规划。
十、常用实测与监控工具
- 聊天机器人 / 智能客服:最优先 TTFT、TPOT(单流出字速度);次要关注 系统并发 QPS、P95 延迟;可适当妥协 Prefill 极限吞吐
- 长文档分析 / 知识库问答:最优先 Prefill 吞吐、端到端处理耗时;次要关注 系统总吞吐;可适当妥协 首字 TTFT 绝对值
- Agent / 自动化工具:最优先 工具调用分层准确率、TTFT、P95;次要关注 格式遵循稳定性;可适当妥协 极端并发吞吐
- 离线数据批量处理:最优先 系统总吞吐(tok/s)、单 Token 成本;次要关注 任务整体完成时间;可适当妥协 交互响应延迟
- 超长上下文 RAG:最优先 KV Cache 容量、Prefix Cache 命中率;次要关注 长上下文 Decode 衰减率;可适当妥协 首字延迟
工具推荐:
- 推理引擎内置工具
- vllm bench serve / SGLang 压测套件:快速测试 TTFT、TPOT、系统吞吐与投机采样接受率
- 专业性能压测工具
- NVIDIA GenAI-Perf:标准化大模型压测工具,输出符合 MLPerf 规范的 TTFT/TPOT 分位数与每百万 Token 成本核算
- 质量与精度评测框架
- EvalScope / lm-evaluation-harness:用于量化前后、参数调优前后的 Benchmark 精度回归(涵盖 IFEval、HumanEval、GSM8K 等)
- 硬件与运行时监控
- Prometheus + Grafana:对接推理框架暴露的 /metrics 端点,持续监控 P95/P99 延迟、排队时间与显存使用率
- nvidia-smi / gpustat:实时观察 GPU 算力利用率、显存分配与功耗
相关链接:
- 实测模型:https://huggingface.co/inclusionAI/Ling-3.0-flash
- DGX Spark参考配方:https://github.com/sudoingX/dgx-spark-ling
- lm-evaluation-harness:https://github.com/eleutherai/lm-evaluation-harness
- vllm:https://github.com/vllm-project/vllm
本文的定义与参考值部分整理自开源推理社区(vLLM/SGLang/TGI)指标定义、MLPerf Inference 基准体系,以及当前主流硬件规格。第九节及自检清单中标注“样本”的全部数字,来自 2026-08-17 至 08-18 在 DGX Spark 上对 Ling-3.0-flash-INT4 的实测,配置与脚本均可复现。具体数值会随模型版本、量化方案、框架参数和环境变化,实测为准。
内容核验说明
把延迟、吞吐、显存、成本这几类指标拆成可查的定义与参考区间,附 70B 权重占用、KV cache 等算例和硬件选型对照表,方便自建推理时直接查数。适合准备买卡、调吞吐或核算每百万 token 成本的工程与运维。
第一节至第八节的参考区间与社区口径未标注单一出处;第九节在 DGX Spark 上跑 Ling-3.0-flash-INT4 的 TTFT、并发扩展、KV cache 利用率、长上下文降速与投机采样接受率等数字,均来自作者公开披露,诀.com 未独立验证,作者虽称配置与脚本可复现,但结果会随模型版本、量化方案、框架参数与环境变化,不保证复现。评论区整合
根据评论整合来看,多数回复认可这套指标清单对新手友好,有人打算下载 Ling-3.0 Tiny 本地试跑,也有人提到小内存 Mac 能直接跑。补充经验集中在两点:exl3/nvfp4 量化在做好时可接近全精度质量;设备选型应按大时间尺度的总吞吐除以购置、优化与电费成本来算。有回复主张 KV 池应尽量开大,否则并发上来命中率过低反而拖累吞吐,与原文调低利用率的建议形成对照。长上下文降速曲线被多条回复提及,认为基准测点应放在 8K–16K 中段而非首尾两端。
基于原帖公开评论整理,只反映讨论中的观点与反馈,不代表诀.com 立场。原始来源
原作者:WquGuru(@wquguru)
本文对公开来源内容进行了结构化整理,原观点与内容归原作者所有。
查看原文