Crawl4AI:把网页转成 LLM 可用 Markdown 的爬虫
Crawl4AI 是 unclecode 开源的 Python 爬虫库,把任意网页渲染后转成干净的 Markdown 或按 schema 抽出的 JSON,供 RAG 与 AI Agent 使用。这篇文章拆解它的主要功能、安装方式、关键参数与真实用户踩过的坑,并把它和两个同类抓取框架放在一起比较,帮你判断该不该自建。
把网页喂给大模型这件事,卡点在中间那一层。RAG 要的是干净正文,Agent 要的是能直接读的结构化数据,而原始 HTML 里混着导航栏、广告位、脚本和内联样式,整段丢给模型既烧 token 又干扰判断。Crawl4AI 做的是这层转换:起一个真实浏览器把页面渲染完,剥掉样板内容,输出 Markdown 或按 schema 抽好的 JSON。
Crawl4AI 是 Python 写的开源爬虫库,把网页转成适配 LLM 的干净 Markdown,并按 CSS/XPath 或大模型抽取结构化 JSON,供 RAG 和 AI Agent 使用。
它有两种用法。一种是把库装进自己的 Python 进程,浏览器也跑在本地,永久免费,浏览器和代理的事全归自己管;另一种是官方托管的 Crawl4AI Cloud,拿一个 key 就能调 /scrape、/search、/extract 这些接口,浏览器与反爬由服务方处理。两种用法共用同一套输出格式,切换成本主要在是否愿意按量付费。
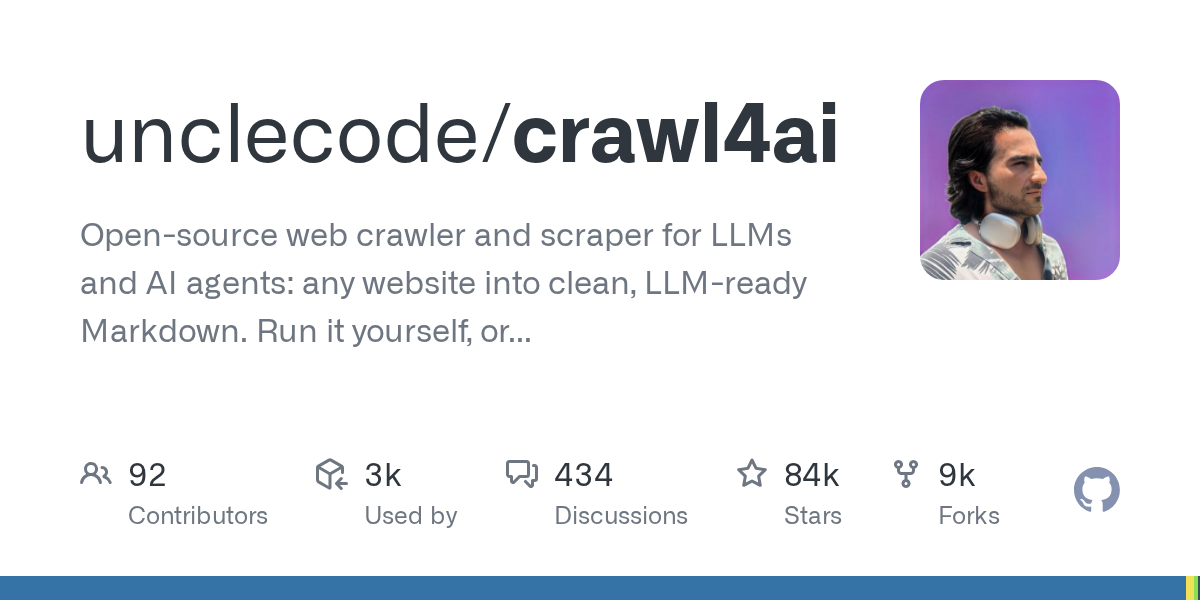
仓库当前是 Apache-2.0 许可证,主要语言 Python,占比 98.8%。Star 84343,Fork 8722,Watcher 419,开放 Issue 207。项目创建于 2024 年 5 月 9 日,最近一次提交在 2026 年 9 月 25 日,最新版本 v0.9.4 发布于 2026 年 9 月 23 日。仓库地址是 https://github.com/unclecode/crawl4ai。
主要功能
Markdown 生成。把页面转成标题、列表、表格、代码块齐全的文本,结构按 LLM 好读的方式组织。Fit Markdown 负责过滤菜单、页脚和样板内容,提供 PruningContentFilterLXML、BM25ContentFilter 和 LLMContentFilter 三个过滤器,其中 BM25ContentFilter 面向查询做筛选。页面里的链接会变成编号引用列表。生成策略可替换成自定义实现。
结构化数据抽取。不调模型的快速路径有 JsonCssExtractionStrategy、JsonXPathExtractionStrategy 和 RegexExtractionStrategy。generate_schema 能根据一次描述生成可复用的 schema。要按语义抽取就用 LLMExtractionStrategy,可接任意 LLM 提供方,输出带类型的 JSON schema。长页面支持按主题、正则或句子切块,CosineStrategy 用余弦相似度挑出与查询相关的块。
浏览器控制。浏览器 profile 可以持久化,登录态、cookie 和设置都能留着;也能通过 Chrome DevTools Protocol 接远程浏览器。多步爬取之间用 session 保持状态。代理支持认证与轮换。开启 enable_stealth 走隐身模式,仓库另配了 undetected-browser 适配器,用于检测自动化行为的站点。headers、cookies、user agent 和 viewport 都可改。引擎覆盖 Chromium、Firefox 和 WebKit。
爬取与抓取调度。深度爬支持 BFS、DFS 和 best-first 三种策略,长任务能用 resume_state 恢复。AdaptiveCrawler 在学到足够回答查询的信息后停止。AsyncUrlSeeder 从 sitemap 和 Common Crawl 发现 URL,DomainMapper 做域名映射,打开 prefetch=True 后找 URL 的速度比常规路径快 5 到 10 倍。动态页面可以执行 JavaScript、等待元素出现,用 scan_full_page 整页滚动应付无限滚动与懒加载图片。页面能截图、导出 PDF,图片、音视频、srcset、内链外链、iframe 和 metadata 都会被解析。raw: 前缀读原始 HTML,file:// 读本地文件。每个爬取步骤都留有 hook,重复抓取走缓存,arun_many 配合内存自适应调度器一次处理多个 URL。
自托管 Docker 服务。每个端点都要求带 CRAWL4AI_API_TOKEN。REST 端点包括 /md、/html、/crawl、/crawl/stream、/screenshot、/pdf 和 /execute_js。MCP 可以把 Claude Code 这类 agent 接到自己的服务器上。服务自带监控面板和 playground,以及一个预热过的浏览器池。镜像同时构建 AMD64 与 ARM64。
云服务。同一个 key 走 /scrape、/search、/answer 和 /extract,批量任务用 /scrape/batch 与 /scrape/jobs。单次流式调用最多 50 个 URL,后台作业最多 10000 个。新用户首笔 10 美元额度限期赠送,截止 2026 年 12 月 31 日,无需绑卡。
安装与依赖
本地跑库的最短路径是两条命令,第二条装浏览器,只需执行一次。
pip install -U crawl4ai
crawl4ai-setup
想跑成服务,仓库根目录提供了 docker-compose.yml 与 Dockerfile,可直接用 Docker 起。仓库节选里没有写明支持的最低 Python 版本。
最短能跑通的用法
文档给出的最小示例是异步创建一个 AsyncWebCrawler,抓一个 URL,把结果里的 markdown 打印出来。
import asyncio
from crawl4ai import AsyncWebCrawler

async def main():
    async with AsyncWebCrawler() as crawler:
        result = await crawler.arun(url="https://news.ycombinator.com")
        print(result.markdown)

asyncio.run(main())
不想自己跑浏览器的话,云接口用一个 curl 就能验证,返回体里取 markdown 字段。
curl -s https://api.crawl4ai.com/scrape \
  -H "Authorization: Bearer $CRAWL4AI_KEY" \
  -H "Content-Type: application/json" \
  -d '{"url": "https://news.ycombinator.com"}' | jq -r .markdown
关键参数
arun 的核心参数是 url。输出内容的裁剪由 Markdown 生成器上的过滤器决定,PruningContentFilterLXML 按结构剪,BM25ContentFilter 按查询相关性剪,LLMContentFilter 交给模型判断。整页滚动用 scan_full_page,反检测用 enable_stealth。批量抓取走 arun_many,长任务断点续爬用 resume_state,URL 预发现打开 prefetch。自托管服务侧,鉴权头字段是 CRAWL4AI_API_TOKEN。
结果在哪里看
Python 侧的结果都在返回对象上,result.markdown 是正文 Markdown,result.media 收纳图片、音频和视频,result.links 给出内外链。截图与 PDF 由对应能力产出文件。Docker 服务通过 /md、/html、/screenshot、/pdf 这些端点直接把结果返回给调用方。云端走 REST 接口,返回 JSON,用 jq 取字段即可,仓库没有为每种输出形态单独说明落盘方式。
实际使用中的坑
Issue 里出现频率最高的一类问题是浏览器生命周期。有用户遇到 Page.content: Target page, context or browser has been closed,抓取中途页面或浏览器被关掉,这条已有 36 条评论,状态是已解决。
部署环境的匹配问题也不少。有人用 AWS Lambda 打包 Docker 镜像时撞上只读文件系统的报错,原因是容器里写文件的路径不可写;另一个常见报错是镜像平台 linux/arm64/v8 与宿主机 linux/amd64/v3 不匹配,拉错了架构。两条都已解决。
Windows 上曾有 NotImplementedError in asyncio.create_subprocess_exec,Windows 的事件循环不支持这一调用,同样已经修掉。
还有一条仍然待解决。用 scroll_full_page 提取数据时,只有最后加载出来的元素能被解析到,用户抓 Twitter 的 following 列表时碰到,22 条评论,目前没有关闭。滚动类站点要用这个能力,需要自己再做一层校验。
同类项目对比
下面三个项目都做网页数据抓取,但切入点不同,放在一起看取舍更清楚。
| 项目 | 适合谁 | 部署方式 | 主要限制 | 什么情况下选它更合适 | 项目地址 |
|---|---|---|---|---|---|
| Crawl4AI | 要给 RAG 或 AI Agent 供网页数据的 Python 开发者 | pip 装库,或用 Docker 自托管服务,也可走官方云 | 需要真实浏览器参与,占一份浏览器进程;Docker 镜像存在平台匹配问题;云服务按量付费 | 需要 LLM-ready 的 Markdown 输出与 schema 抽取,且想自己掌控浏览器、代理和会话 | Crawl4AI |
| ScrapeGraphAI/Scrapegraph-ai | 想用自然语言描述抽取目标、少写选择器的开发者 | pip 安装 Python 包 | 未逐一核实 | 抽取逻辑主要由提示词驱动、你希望少维护选择器时 | ScrapeGraphAI/Scrapegraph-ai |
| D4Vinci/Scrapling | 需要从单次请求一路扩到全站爬取的抓取工程 | pip 安装 Python 包 | 仓库描述里未提及面向 LLM 的 Markdown 输出格式 | 任务重心在抓取调度与自适应解析、下游不接大模型时 | D4Vinci/Scrapling |
Crawl4AI 的位置在输出层。它的力气花在把页面整理成模型能直接消化的形状,抓取调度只是配套。要做的是几百个页面的字段提取,下游既不需要 Markdown 也不接模型,Scrapling 这类框架更贴题;抽取规则本身想用自然语言维护,ScrapeGraphAI 的路径更短。反过来说,一旦链路末端是大模型,Crawl4AI 省掉的清洗和拼装工作最多。
合规边界
Crawl4AI 是爬取工具,用之前先划定范围。只对自有资产或已获授权的目标发起抓取,包括你自己运营的站点、拿到书面许可的数据源、以及明确允许抓取的公开接口。绕过登录墙、突破反爬机制、高频请求压垮对方服务,这些做法会带来法律风险和平台封禁,隐身模式与 undetected-browser 这类能力本身不构成授权。抓取前对照目标站点的 robots.txt 与服务条款,涉及个人信息时还要看当地的数据保护法规。
适合谁
做 RAG 或 AI Agent、需要稳定把网页变成 Markdown 或结构化 JSON 的 Python 开发者,适合用这个项目。手上已经有一套浏览器自动化脚本、只想加一个正文提取步骤的人,装库即可接入。要在内网自托管一套抓取服务、给多个 agent 共用的人,Docker 那套加上 token 鉴权够用。抓取量小、页面结构简单、不需要模型参与的团队,用更轻的 HTTP 抓取方案就够了,引入一个浏览器进程并不划算。
焚评:这个项目的量化评分
本项目的选题来自 焚.com(一个按公开公式给 GitHub 项目打分的站)。焚评当前总分 10.0 分(满分 10)。下表是各维度的得分:
| 评分维度 | 得分 |
|---|---|
| 热度动量(权重 25%) | 10.0 / 10 |
| 开发活跃(权重 25%) | 10.0 / 10 |
| 社区响应(权重 15%) | 10.0 / 10 |
| 文档质量(权重 15%) | 10.0 / 10 |
| 发布节奏(权重 10%) | 9.9 / 10 |
| 风险控制(权重 10%) | 10.0 / 10 |
评分口径、权重与计算方式见焚.com 的评分方法页;数据随 GitHub 指标刷新,具体数值以焚.com 当前页面为准。本文正文为诀.com 独立撰写,评分数据由焚.com 授权引用。
内容核验说明
收录理由是它把 Crawl4AI 的能力、参数与踩坑记录摊开,并给出同类项目的取舍对照。自托管与云服务共用同一输出格式,切换成本讲得清楚。文中 star、版本、Issue 数与焚评分数均来自公开披露,诀.com 未独立验证,抓取稳定性和反爬效果需按自己的目标站点核验。适合做 RAG 或 Agent、要自建网页转 Markdown 的 Python 开发者;
仓库指标(star、fork、开放 Issue 数、版本号与提交时间)与焚评评分来自项目公开页面及焚.com 授权引用,诀.com 未独立验证;文中的 Issue 案例转述自 GitHub 报告,未做复现测试;安装命令与代码示例未实际运行。用户反馈摘要
根据仓库 Issue 来看,提交者集中报告两类问题。一类是浏览器生命周期与资源释放,包括页面或浏览器中途关闭、容器运行后残留大量 Chrome 进程,以及反复请求 /md 时内存持续增长直至容器崩溃;前两项状态为已解决,内存问题为待解决。另一类是环境与配置,Docker 镜像平台与宿主机架构不匹配、AWS Lambda 只读文件系统报错、Windows 下 asyncio 子进程不支持、模型提供方默认回落到 OpenAI,这些状态均已解决。还有提交者报告 scroll_full_page 只解析到最后加载的元素,状态为待解决。
基于该仓库公开 Issue 整理,只反映提交者报告的现象与诉求,不代表诀.com 立场,也不代表问题已被确认。项目来源与说明
开源项目:unclecode(unclecode)
本文由诀.com 编辑基于该项目的公开信息独立撰写,属原创解读,不是对项目文档的翻译或转载;文中提到的功能与参数以官方仓库为准,代码与文档版权归原作者所有。
查看项目仓库